AIツールを使ってMVを作るとなると、キャラクターを用意して動画化し、音源を合わせ、必要に応じてリップシンクやカメラワークを調整するなど、複数の工程が発生します。
DomoAIの「Omni Reference(オムニリファレンス)」では、画像・動画・音声を同じ生成画面へ読み込み、各素材を参照させた動画を手軽に生成できます。
今回は、DomoAIに追加されたSeedance 2.5とMiniMax H3を使い、AI MVの1シーンを制作してみました。静止画だったキャラクターが髪を揺らしながら踊り、入力音源には含まれていなかった歌声まで加わり驚くほど自然なシーンが数分で出来上がりました。
この記事では、素材の準備から動画生成までの手順や、両モデルの違いを実際の動画とプロンプトを交えて解説します。
\ MiraLab AI限定!下記のリンクから購入で10%OFF /

DomoAIのオムニリファレンスでSeedance 2.5とMiniMax H3を使ってみたレビュー結論
今回の検証では、1人のアニメキャラクターでのAI MVと3人組の実写風AI MVを素材を変えながら何パターンか制作しました。
人物の一貫性はSeedance 2.5とMiniMax H3のどちらも良好でした。3人組の実写風MVでも人数や髪型、衣装を大きく崩さずに動画化できています。
差が目立ったのは、複雑な映像演出を指定した場合です。
Seedance 2.5は、秒数ごとのカット変更や振り付けを細かく反映し、30秒のMVでは画像・動画・音声に指定した役割も別々に取り入れました。人物を維持したまま衣装とステージを途中で変更するなど、複数素材を組み合わせたMV制作では驚くほど完成度の高い結果になっています。
MiniMax H3は、2K設定では実際に2560×1440で出力され、ステレオ2chの音声も生成されました。またアニメーション風の動画では、元の音声素材をそのまま取り入れる正確性もありました。
10秒生成の消費クレジットはMiniMax H3の方がSeedance 2.5より少ないので、目的に応じて使い分けるのが良さそうです。
| 比較項目 | Seedance 2.5 | MiniMax H3 |
|---|---|---|
| 人物の一貫性 | 良好 | 良好 |
| ダンス・カメラワーク | 複雑な振り付けやカット変更まで細かく反映 | 自然に動くが、複雑な構成への追従性は劣る |
| 生成した最大尺 | 30秒 | 10秒 |
| 2K出力 | 非対応 | 2560×1440で確認 |
| ステレオ音声 | 非対応 | ステレオ2chと左右の広がりを確認 |
| 10秒生成時の消費クレジット | 315クレジット(720P) | 120クレジット(768P) |
| 優れていた部分 | 複数素材を使ったMV構成と演出の制御 | 2K・ステレオ音声と生成コスト |
\ MiraLab AI限定!下記のリンクから購入で10%OFF /
DomoAIのSeedance 2.5とMiniMax H3とは?
Seedance 2.5とMiniMax H3は、DomoAIの「Omni Reference(オムニリファレンス)」機能で利用できる動画生成モデルです。
どちらもテキストだけで動画を作るだけでなく、画像・動画・音声を参照素材にできます。今回はモデルを使ってAI MVの1シーンを生成しました。
Seedance 2.5は画像・動画・音声をまとめて参照できる動画生成モデル
Seedance 2.5は、ByteDanceのAI研究組織「Seed」が開発し、2026年7月31日に正式公開した動画生成モデルです。
Seedance 2.0で導入された映像と音声を同時に生成する仕組みを発展させ、テキストだけでなく画像・動画・音声を参照した映像を一発で作れます。
1回で最大30秒まで生成でき、複数回の延長にも対応しました。Seedance 2.0では1回15秒までだったため、単一の短いカットから、複数の展開を含む映像へと扱える範囲が広がっています。
参照素材は最大30枚の画像、10本の動画、10個の音声を同時に入力でき、人物の外見や声、動作、カメラワークなどを指定できます。時間帯を指定して動作や構図を変更する編集、グリーンスクリーン、カメラ視点の編集なども強化されました。
短い動画を生成するだけでなく、複数カットを含む映像制作や後からの修正まで1つのモデルで扱う最新のAI動画生成モデルです。
MiniMax H3もオムニリファレンスで画像・動画・音声から動画を生成できる
MiniMax H3は、中国のAI企業MiniMaxが2026年7月31日に公開したマルチモーダル生成モデルです。
従来のHailuo 01・Hailuo 02では動画生成の基礎性能や処理効率を高めてきましたが、H3ではテキスト、画像、動画、音声を別々の機能として扱わず、1つの文脈として理解する設計へ変更されました。
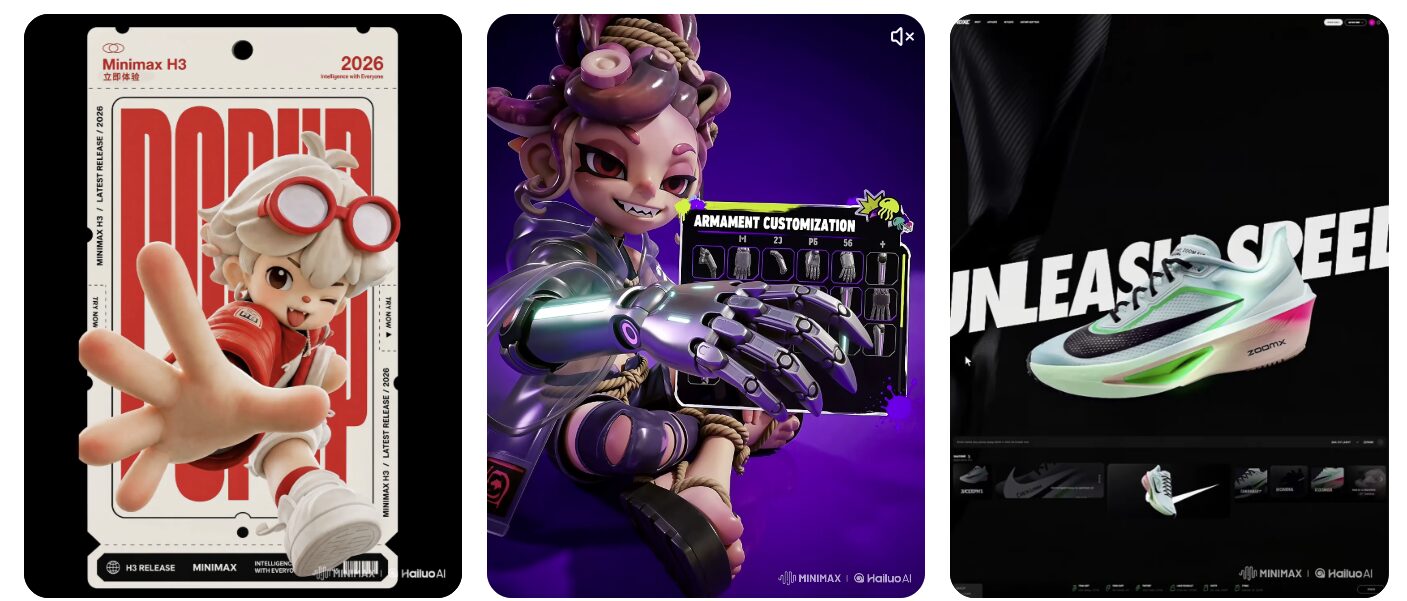
画像の人物に音声を合わせ、別の動画からカメラワークや動きを参照するといった複数素材の指示も、自然言語でまとめて指定できます。
生成動画は4〜15秒で、ネイティブのステレオ音声を同時に生成し、最大2Kの出力にも対応します。従来のようにテキスト→動画生成、画像→動画生成、モーション参照、音声参照などを個別の処理として分けるのではなく、生成・参照・編集を1つのモデルへ統合したことがH3の大きな変更点です。
2026年8月3日にはモデルウェイトも公開され、オープンソースモデルとして利用できるようになりました。
\ MiraLab AI限定!下記のリンクから購入で10%OFF /
DomoAIのオムニリファレンス機能でAI MVを制作するやり方
AI MVで登場させるアニメ風の女性シンガーの画像素材を準備してから、オムニリファレンスでMVを生成する手順を解説します。
DomoAIでAI MVに使用する画像素材を準備
DomoAIのテキスト→画像生成を使って画像を準備します。
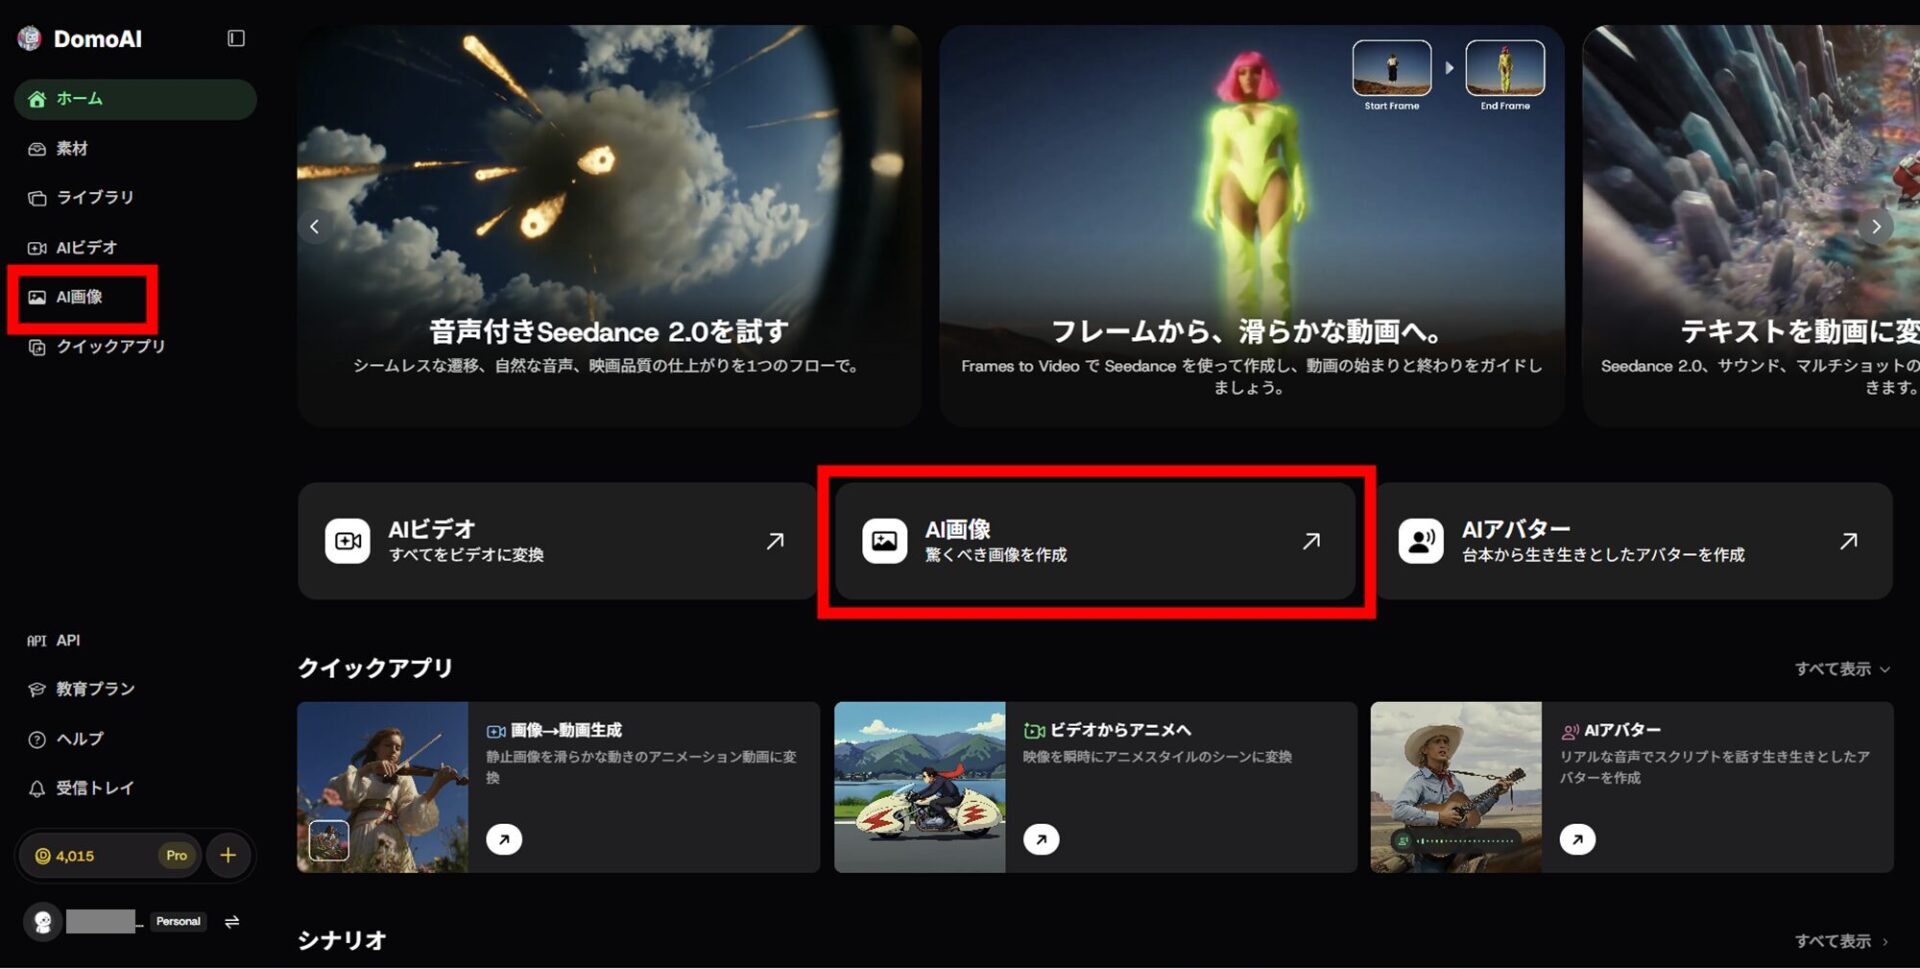
「テキスト→画像生成」のメニューの下にあるモデル選択パネルを開き、好きなモデルを選択します。
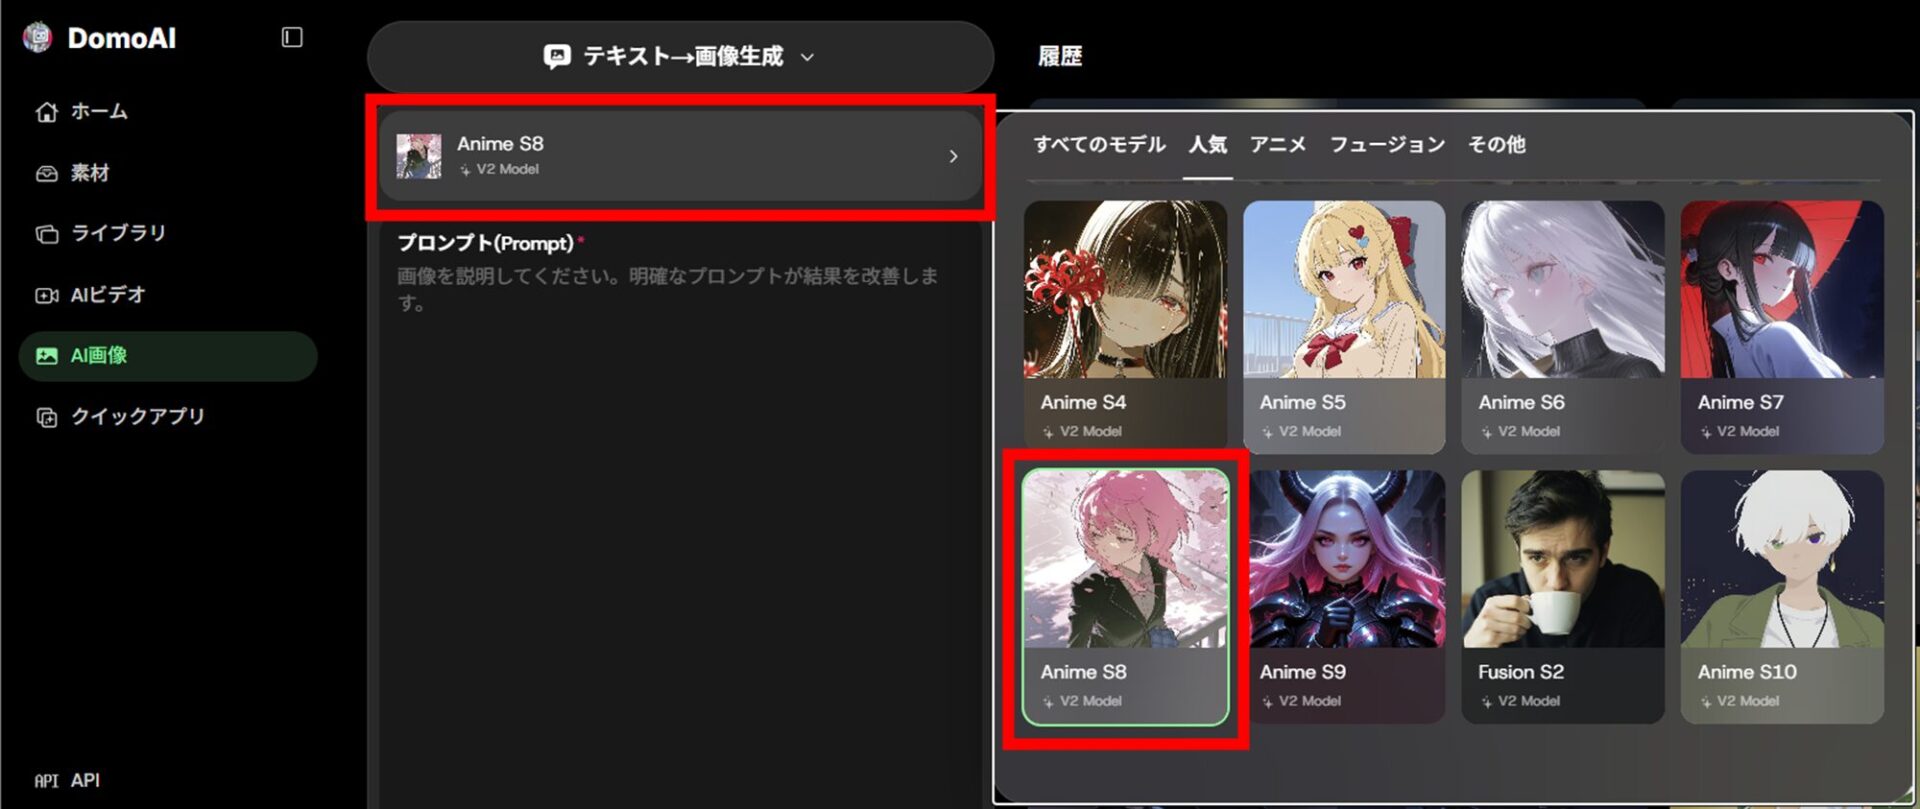
生成する画像の詳細説明(プロンプト)を入力し、必要に応じてアスペクト比を設定したうえで生成に進みます。
プロンプトは以下のとおりです。
A stylish anime female singer standing on a neon-lit rooftop at night, futuristic city skyline in the background, long blonde hair, white dress with subtle stage-fashion details, soft wind in her hair, confident and emotional expression, upper body and arms clearly visible, cinematic music video lighting, purple and cyan neon reflections, dramatic atmosphere, highly detailed anime illustration, clean face, no extra characters, no text, 16:9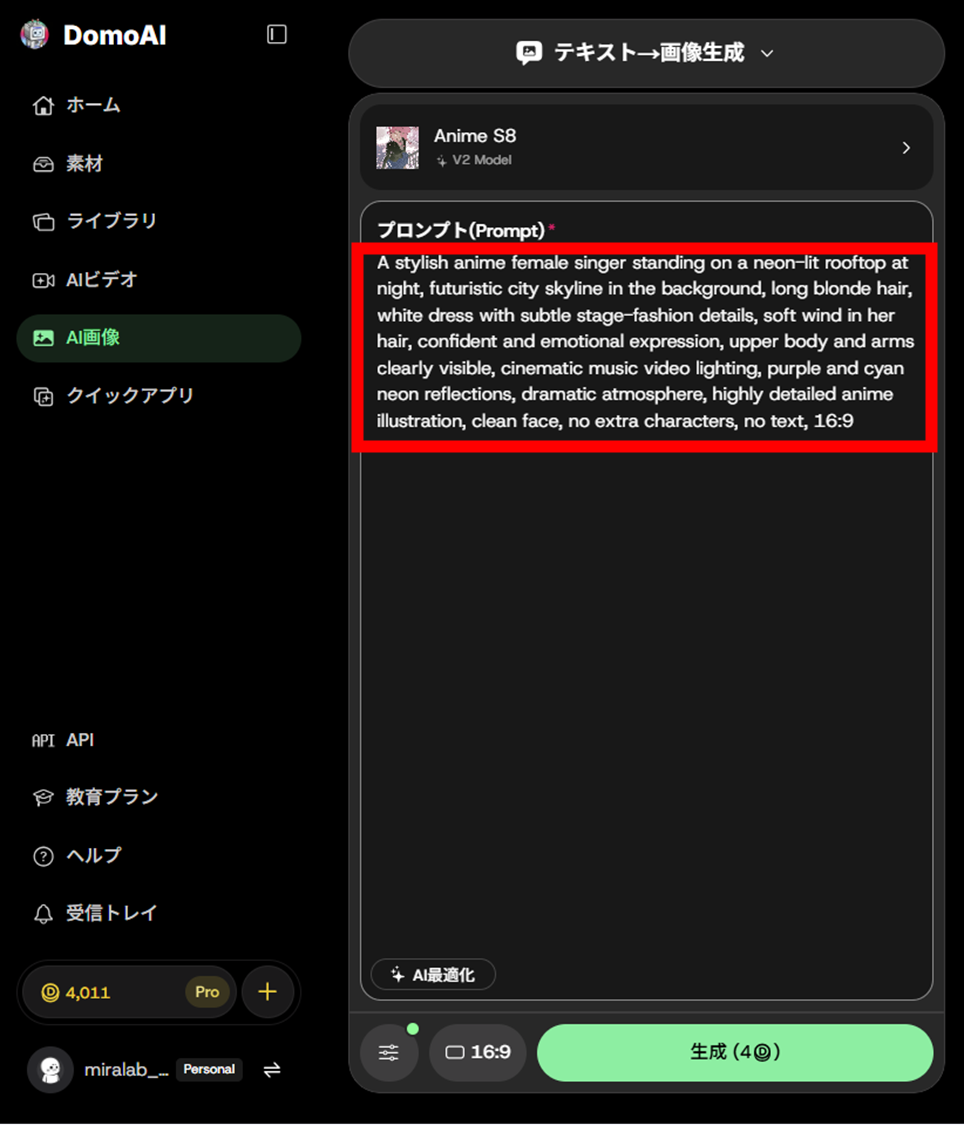
横の履歴欄に生成結果が4枚ほど表示されます。
保存したい画像(例えば右下)をクリックし、保存アイコン(下矢印のアイコン)をクリックします。
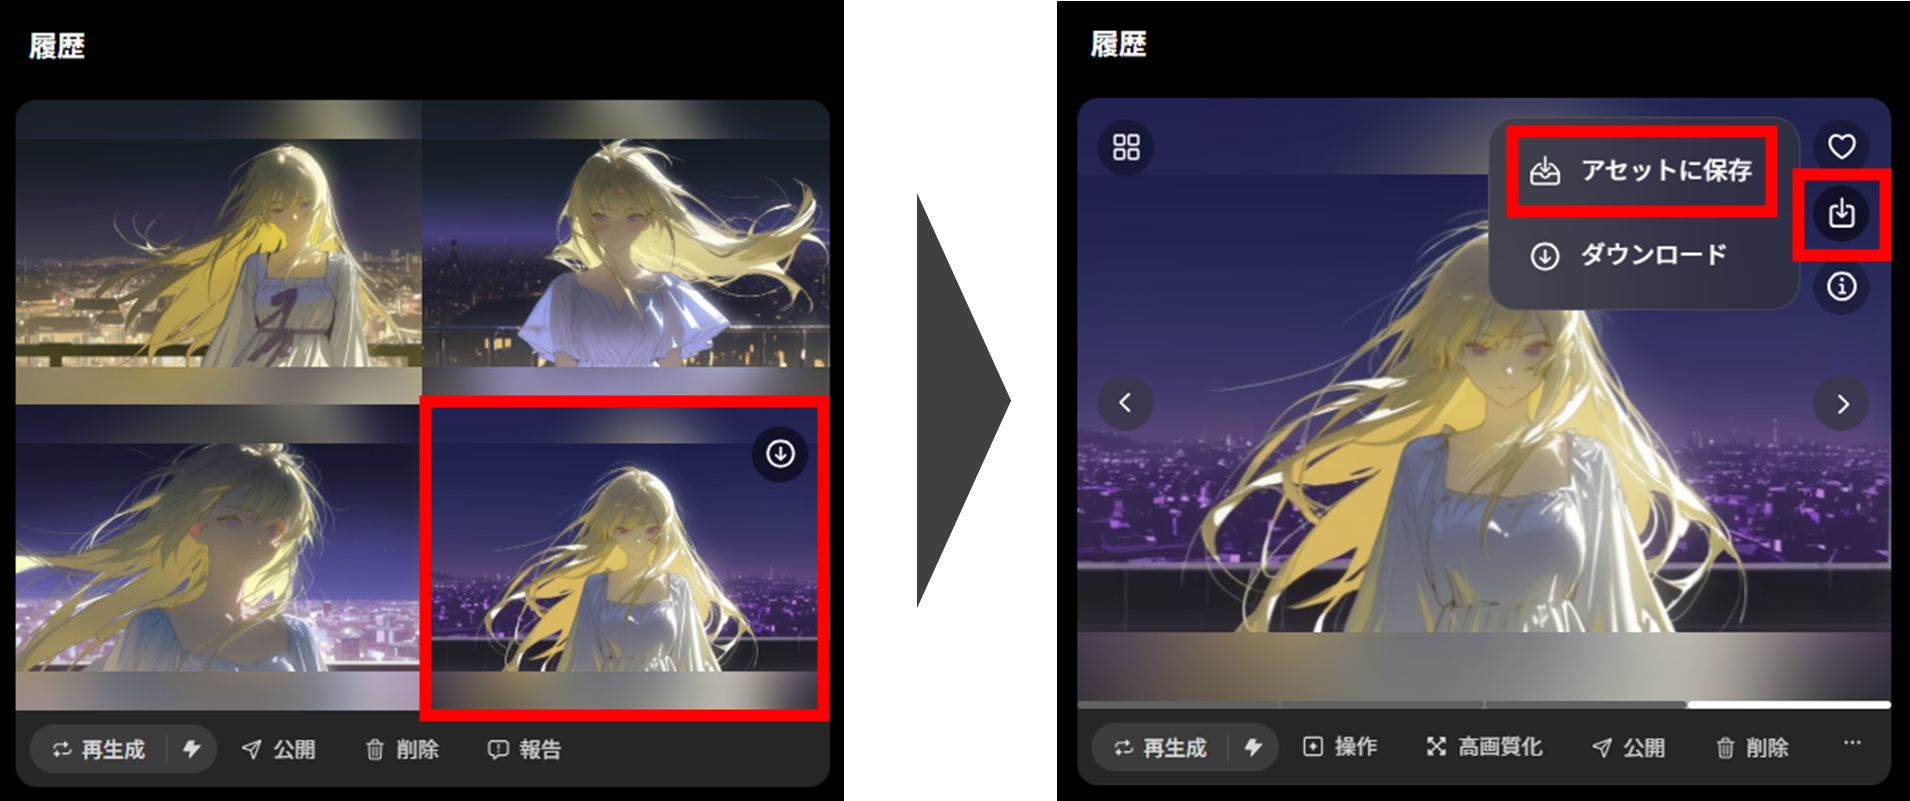
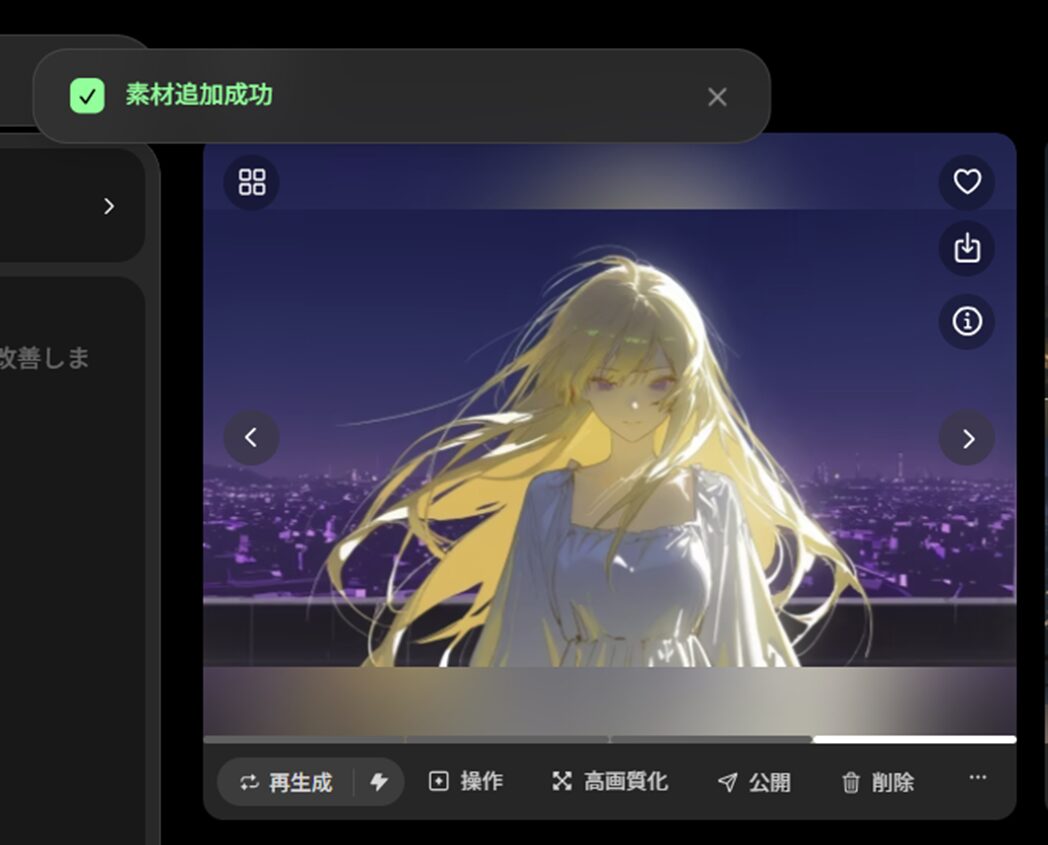
今回は次の動画生成の工程で使えるようにするため「アセットに保存」を選択します。「素材保存成功」と表示されればOKです。
DomoAIのオムニリファレンス機能でAI MVを生成する方法
用意した画像を使って、DomoAIのオムニリファレンス機能で動画を生成する方法を、実際の設定から生成結果まで含めて紹介します。今回は、Seedance 2.5を例として解説します。
左側のメニューから「AIビデオ」機能を選択し、「画像→動画生成」のプルダウンから、「オムニリファレンス」を開きます。
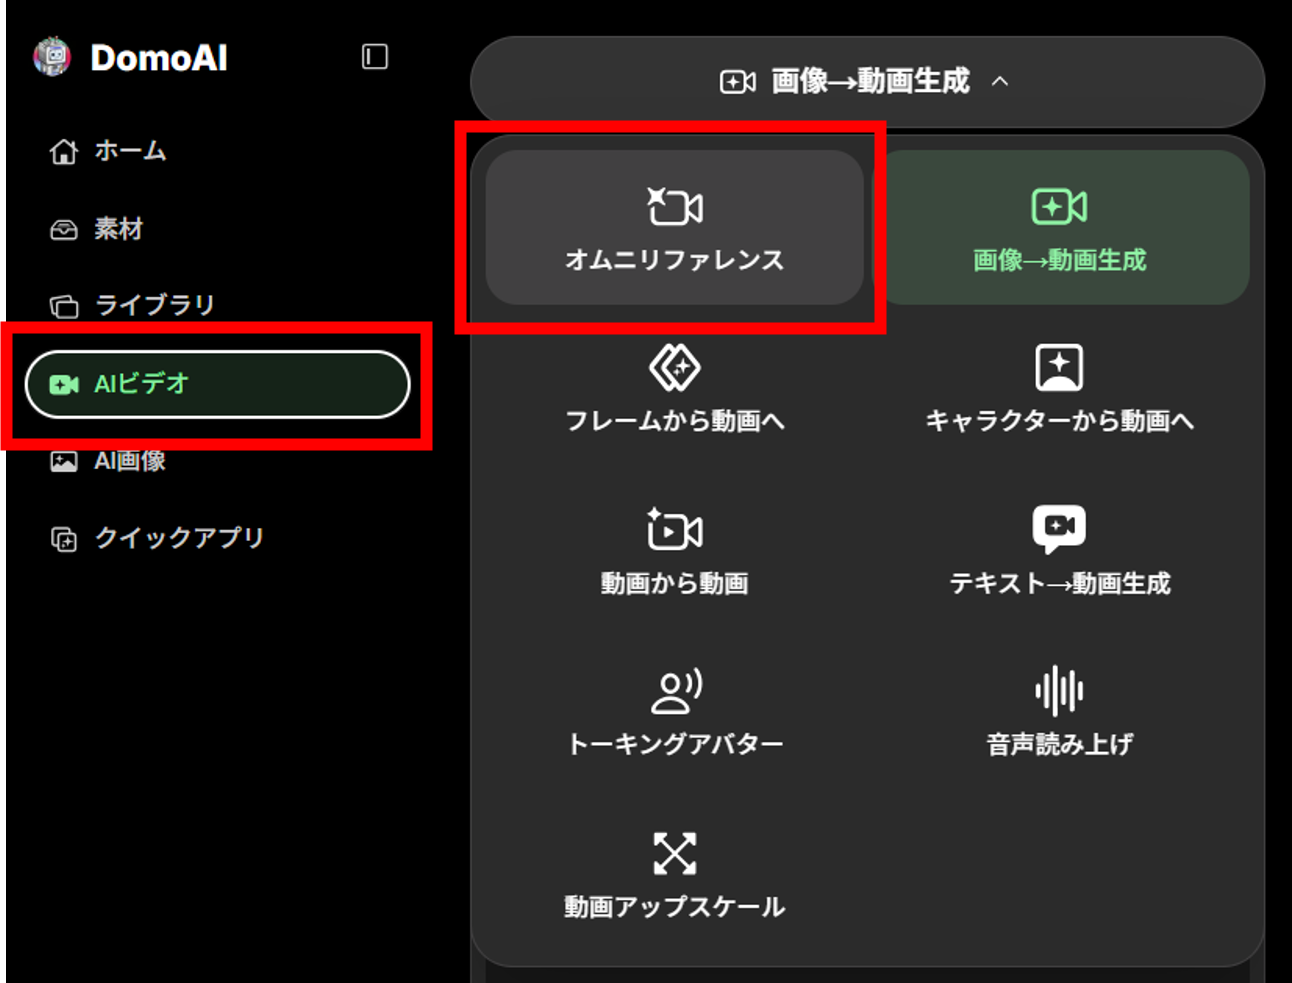
動画生成モデルから「Seedance 2.5」を選択します。
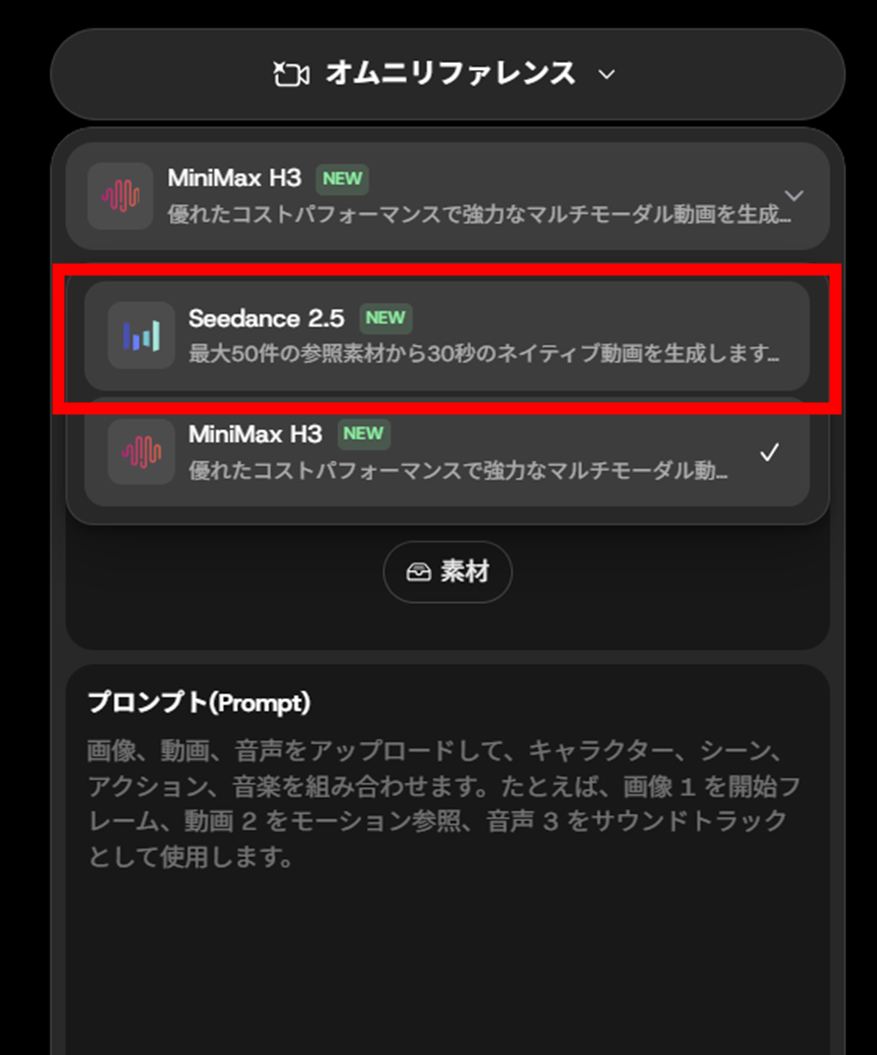
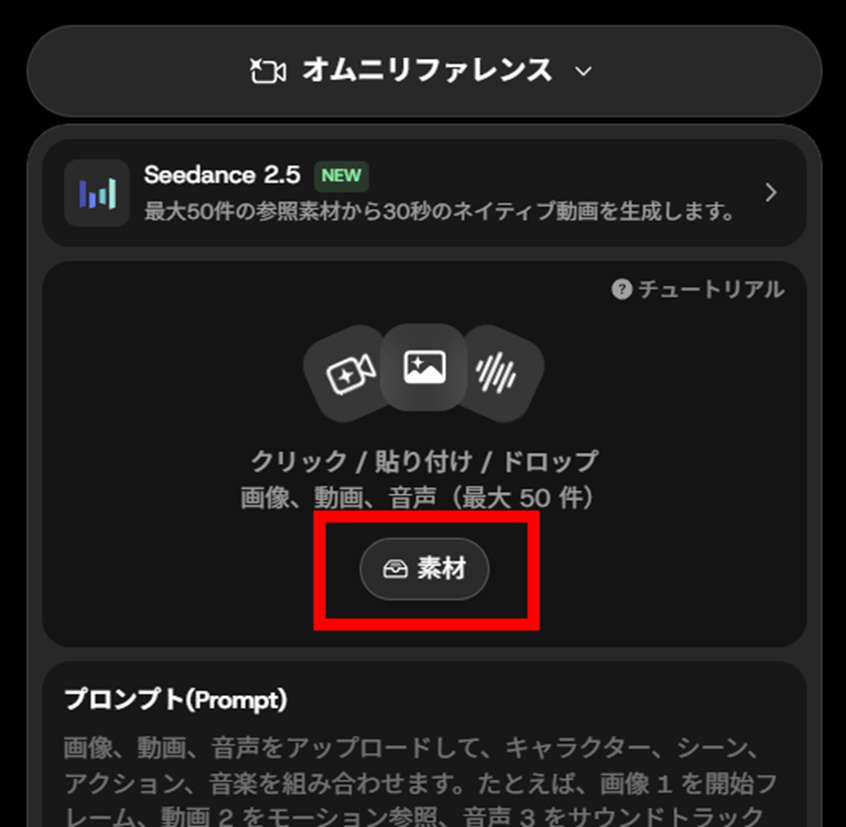
参照画像として、今回は先ほどDomoAI内で生成したキャラクター画像と、別途用意した10秒のオリジナル音源を追加します。まずは「素材」をクリックします。
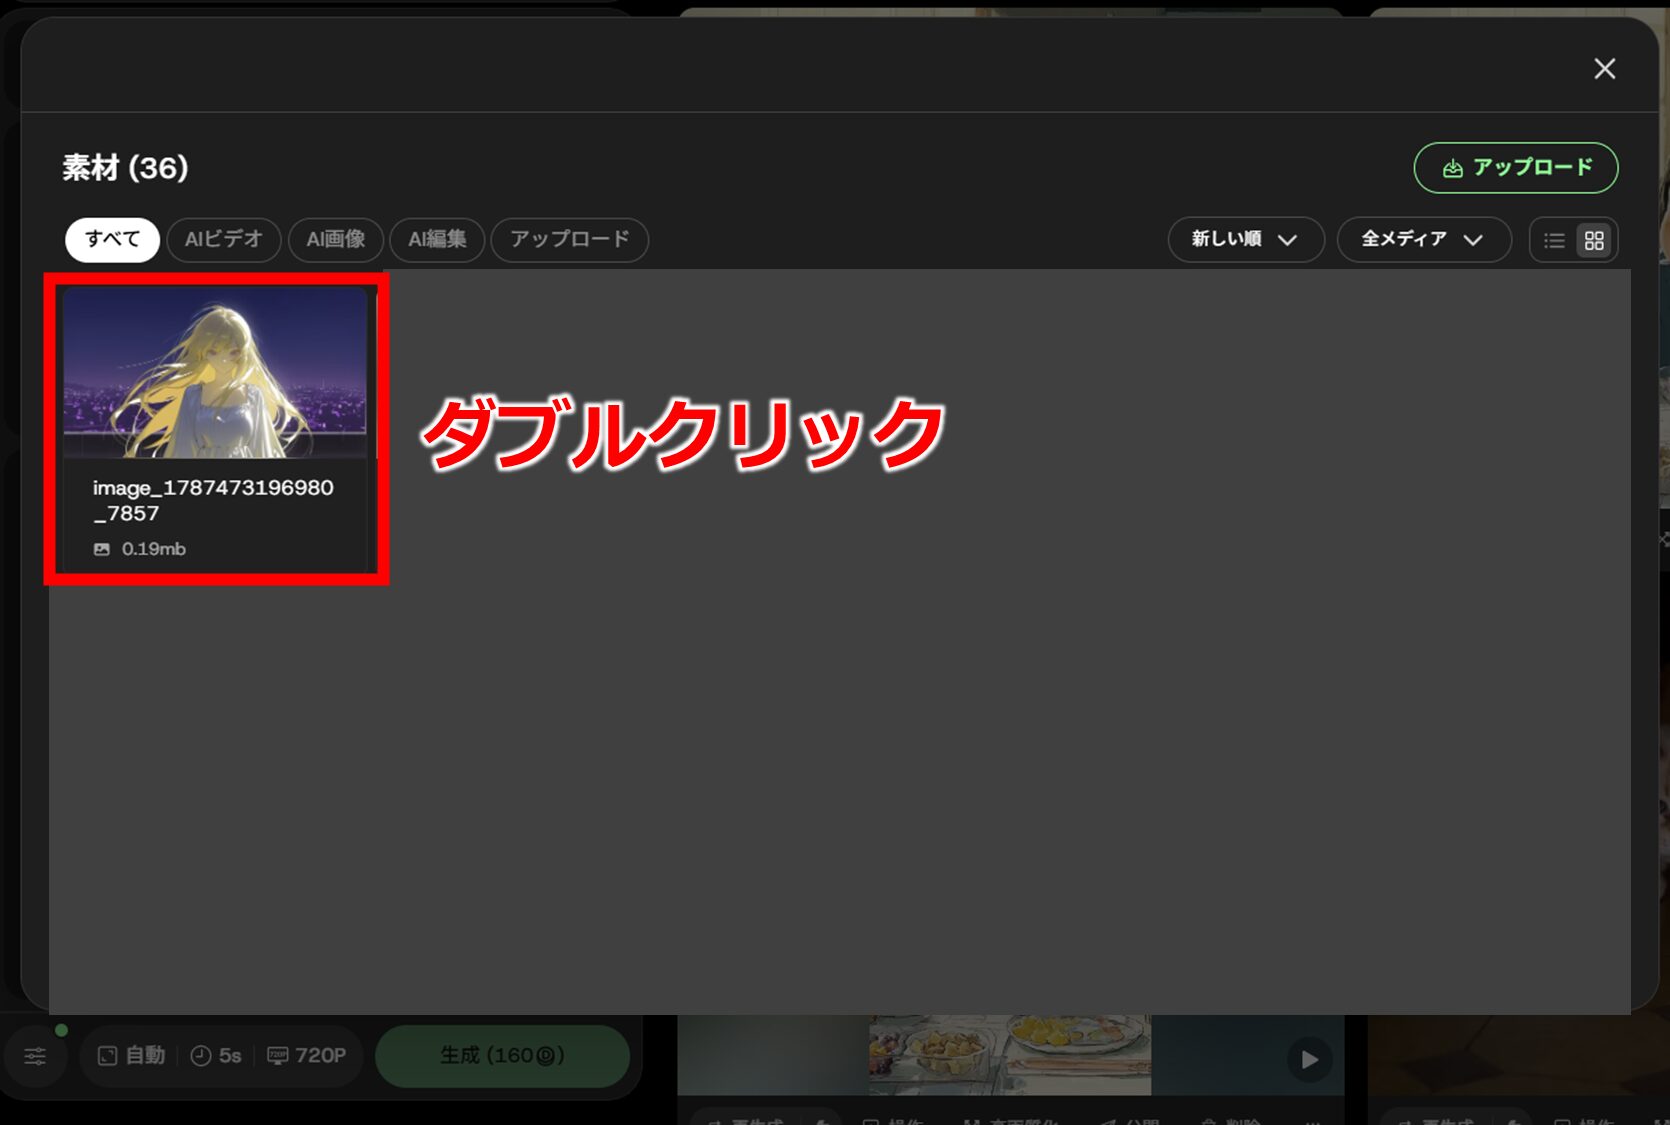
さきほどアセットに追加した素材をダブルクリックして選択します。
オムニリファレンスの画面で、再度「素材」をクリックします。
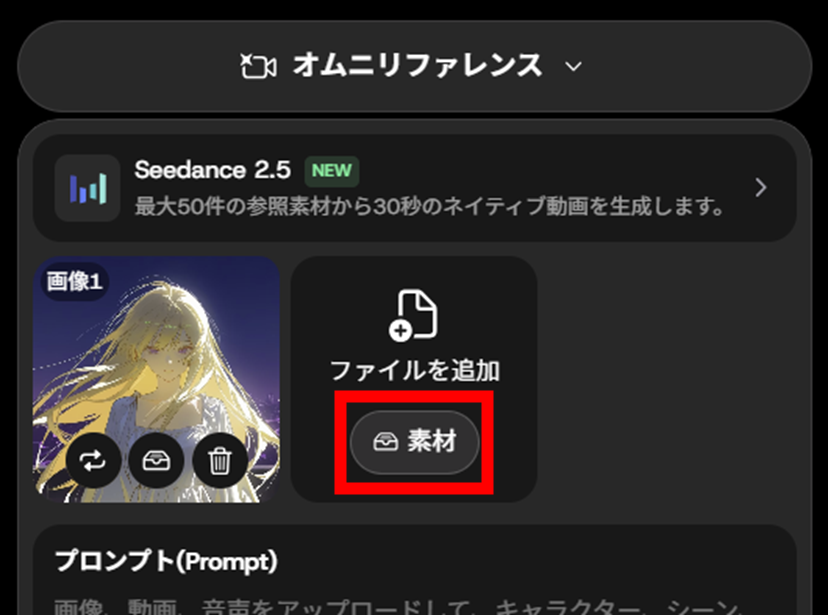
「アップロード」をクリックし、フォルダからファイルを選択してオーディオファイルを追加します。
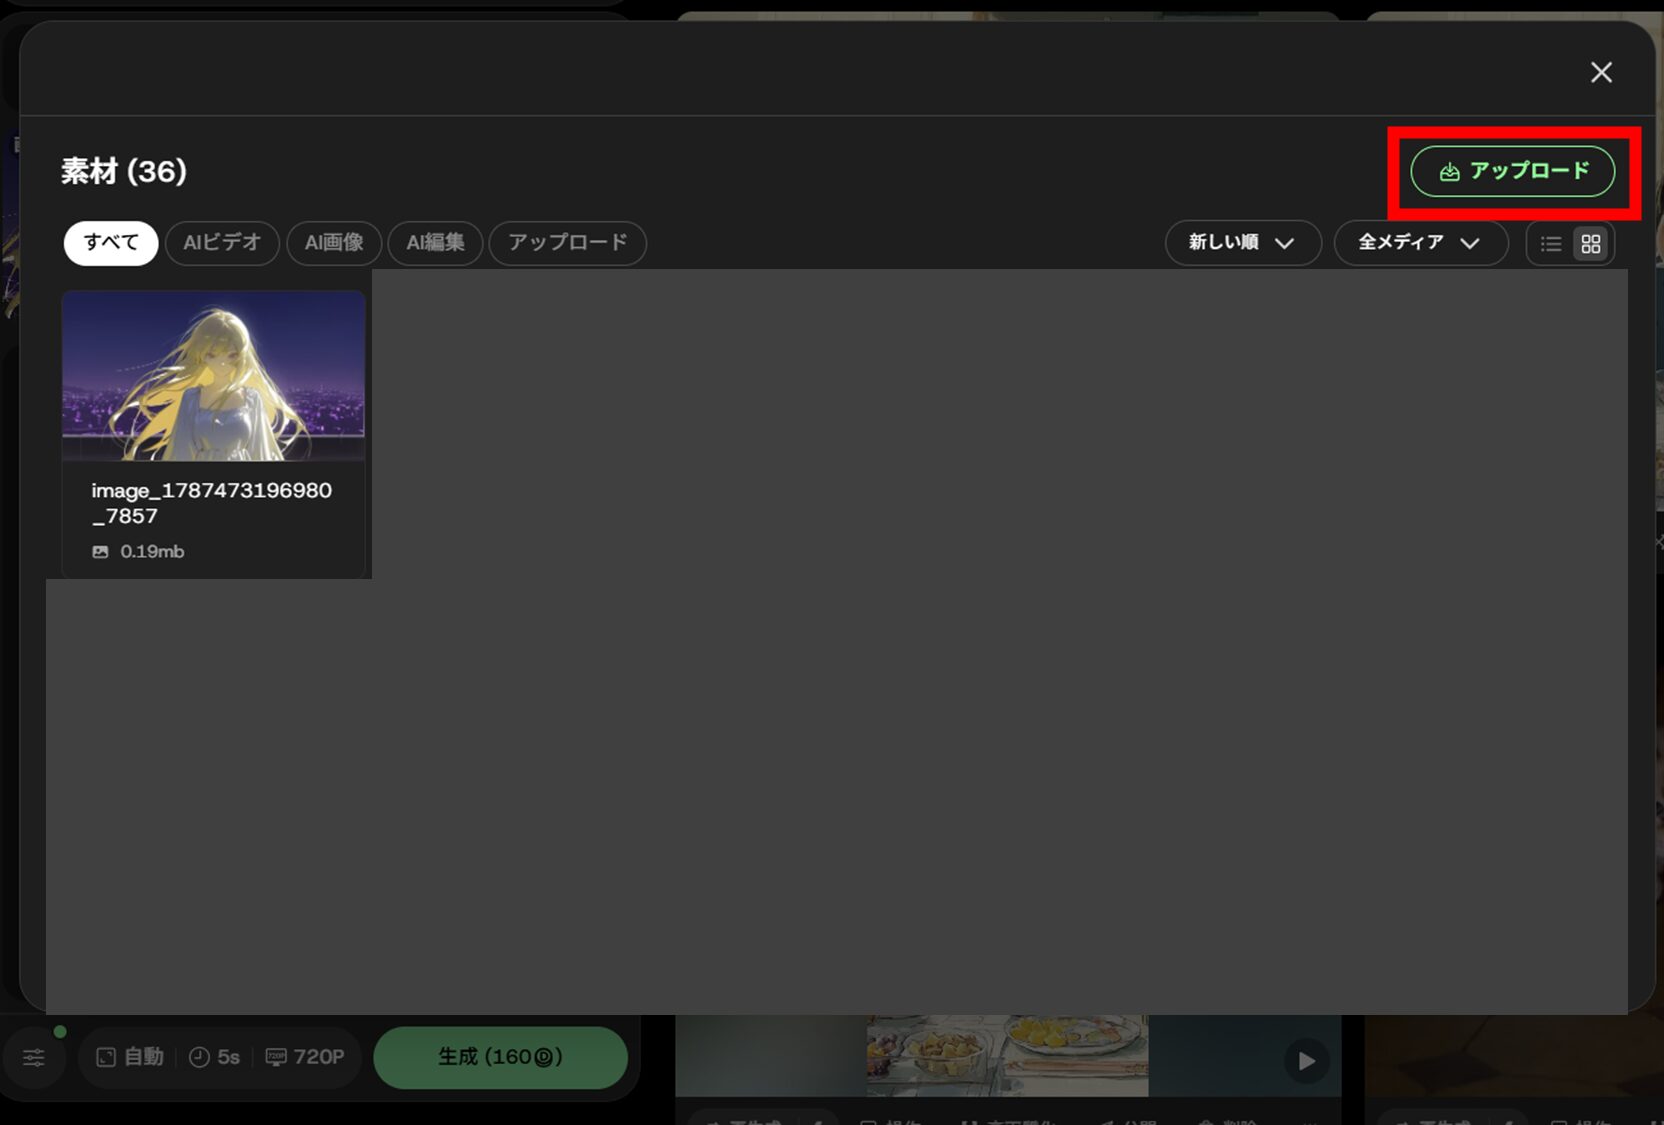
今回の音源は電子音を中心としたインストゥルメンタルで、歌声やセリフは含まれていません。
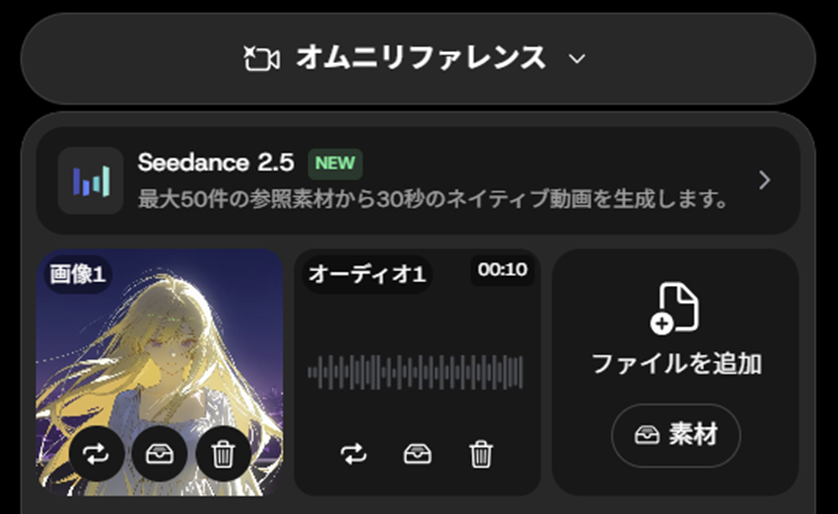
プロンプト欄に動画の詳細を入力します。ここで人物の動きやカメラワークなどをテキストで指示することができます。
今回は、女性が歌いながら上半身を動かす様子に加え、髪と衣装の揺れ、カメラの前進と横移動を指定しました。実際に入力したプロンプトは以下の通りです。
A cinematic anime music video shot of the same blonde female singer from the reference image, standing on a rooftop at night with the city lights in the background. She sings emotionally while gently moving her upper body to the music. Her long hair and white dress flutter in the wind. Keep the same face, hairstyle, and dress. The camera slowly pushes in during the first half, then makes a subtle side move around her during the second half. Preserve one character only. No extra people, no text, no scene cut.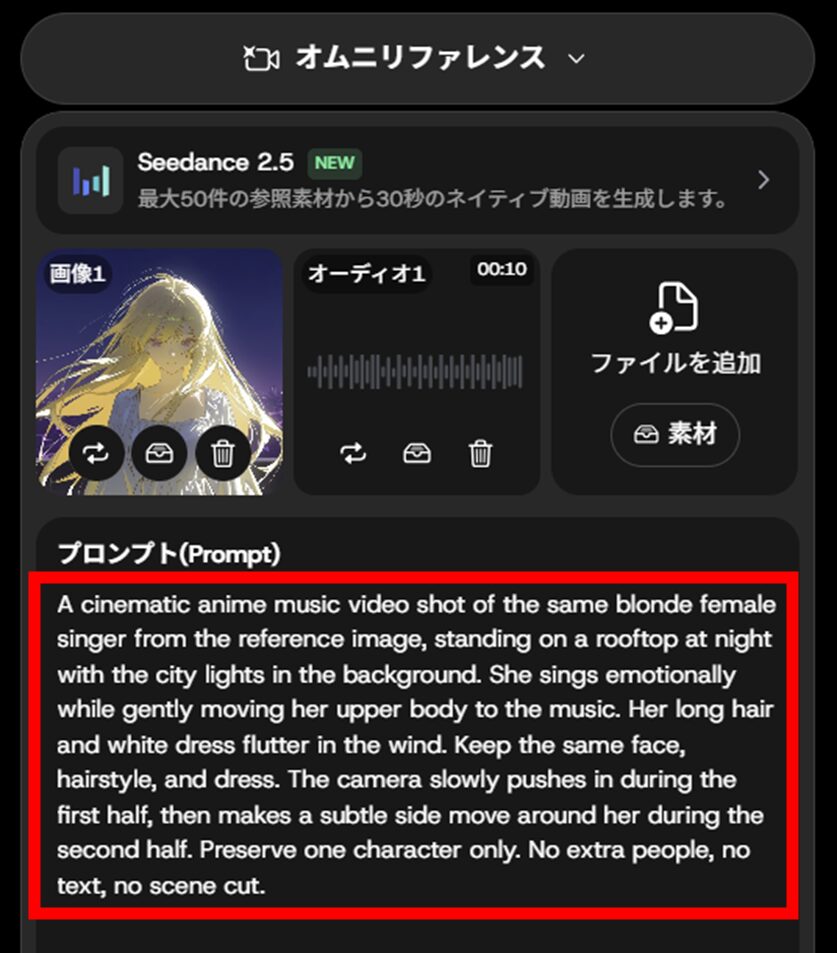
画面下にある設定項目をクリックして設定パネルを表示します。アスペクト比や長さ、解像度などを必要に応じて指定して「生成」をクリックします。
今回はアスペクト比および動画の長さをインプットした素材に合わせ16:9/10秒で設定しました。
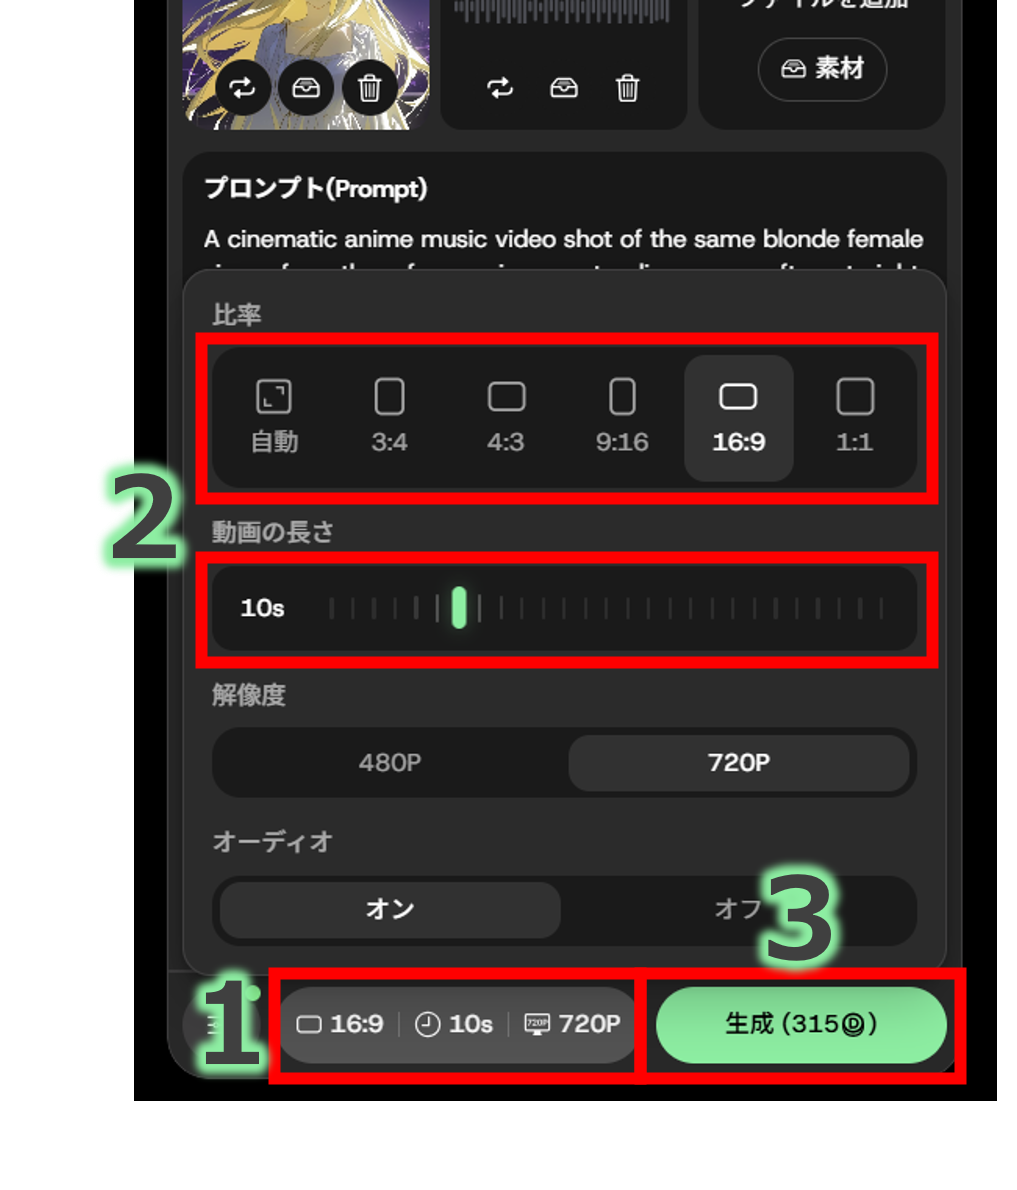
今回の条件では数分ほどで動画が生成されました。履歴にプレビューが表示されたらクリックして動画の内容を確認します。
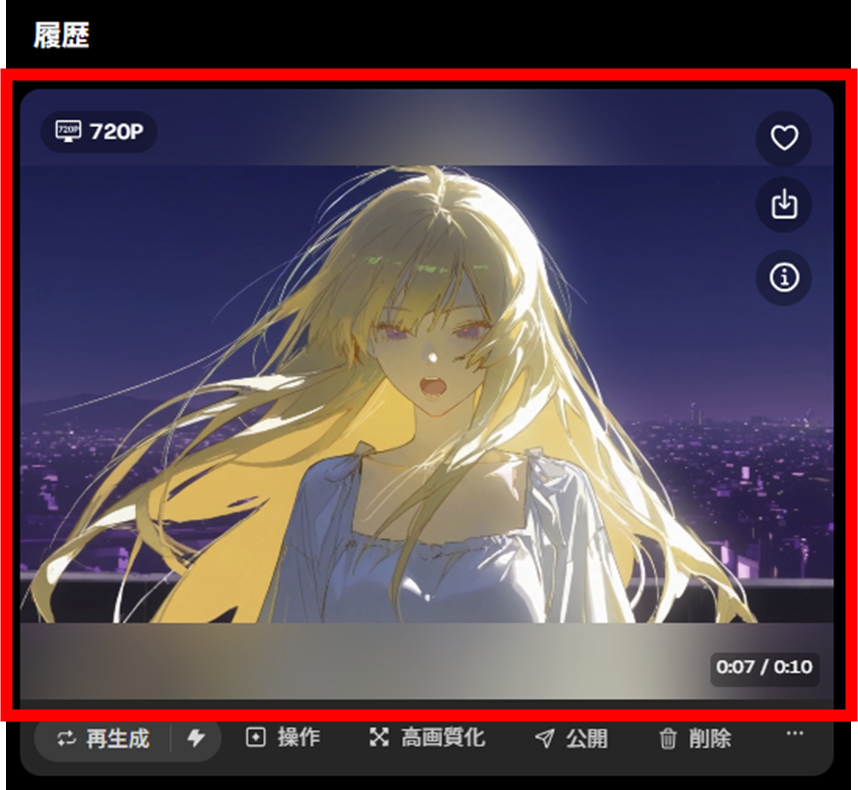
下矢印のアイコンをクリックすると保存できます。
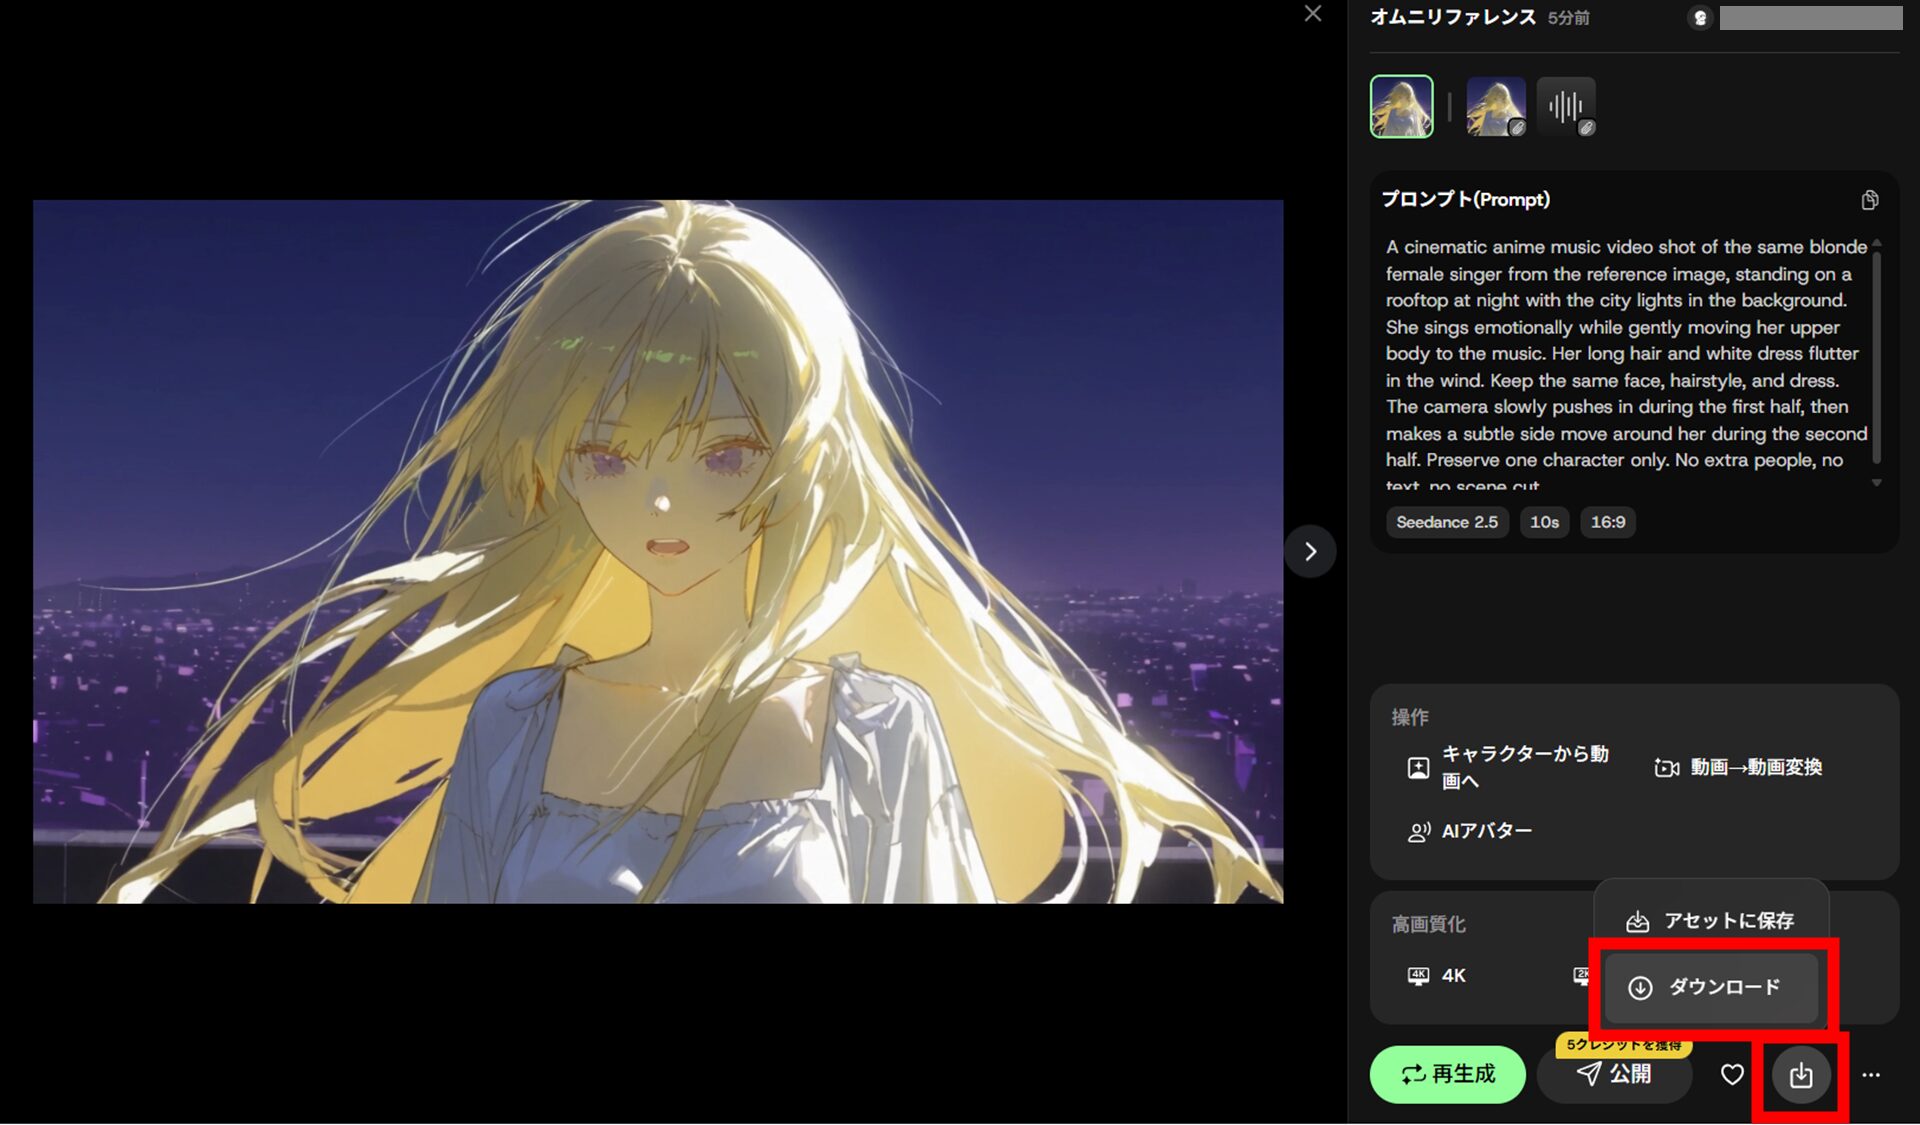
今回生成されたAI MVは以下の動画です。
\ MiraLab AI限定!下記のリンクから購入で10%OFF /
Seedance 2.5で複数素材を参照した30秒MVを制作
3人組の女性ユニットを題材に、画像4枚・動画1本・音声1本を参照させた30秒MVを制作しました。人物、ポーズ、衣装、ステージ、ダンス、カメラワークに別々の素材を指定し、1本の映像へどう反映されるかを見てみましょう。
30秒MV用に参照素材を準備する
今回は、ダンス動画を軸にいくつかのポーズを指定しながら、後半に衣装とステージを変える指示をしました。
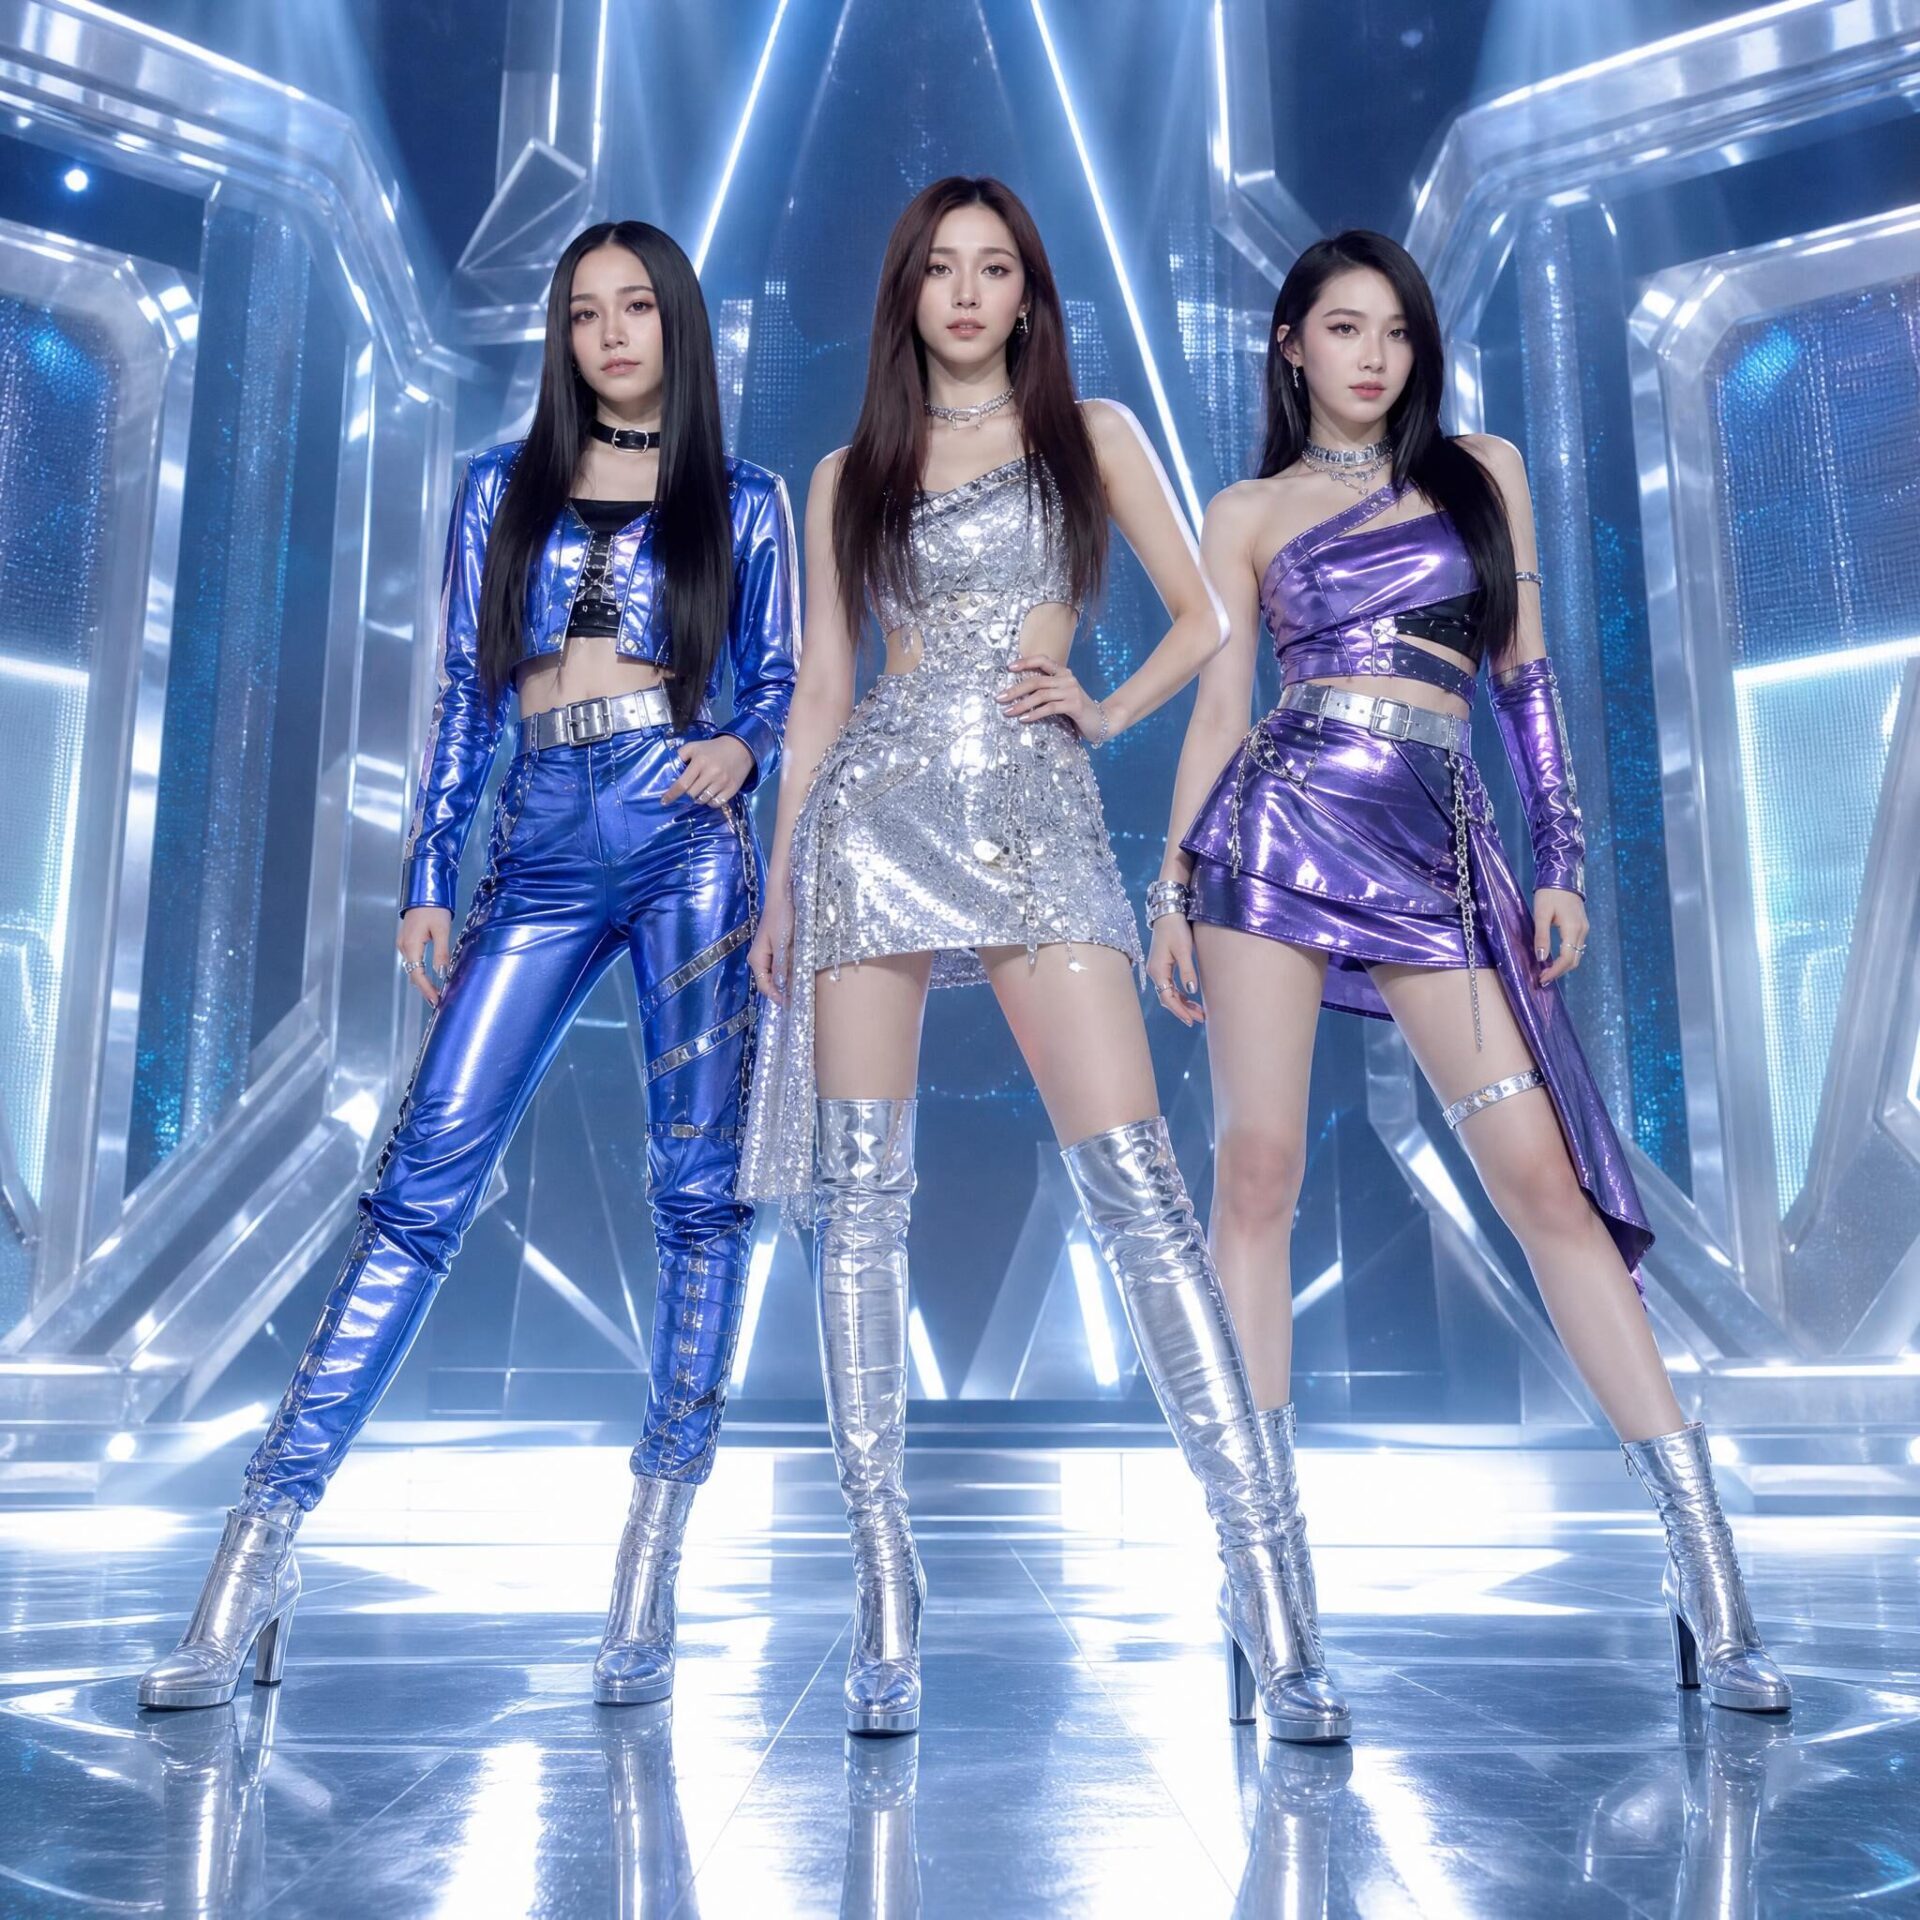
まずは、ベース画像をDomoAIの画像編集で編集し、ダンス途中のポーズ変更画像、終盤の決めポーズ画像、第2コンセプトの3枚を参照画像として作成しました。第2コンセプトでは3人の顔と髪型を残しつつ、衣装とステージのコンセプトを変えています。
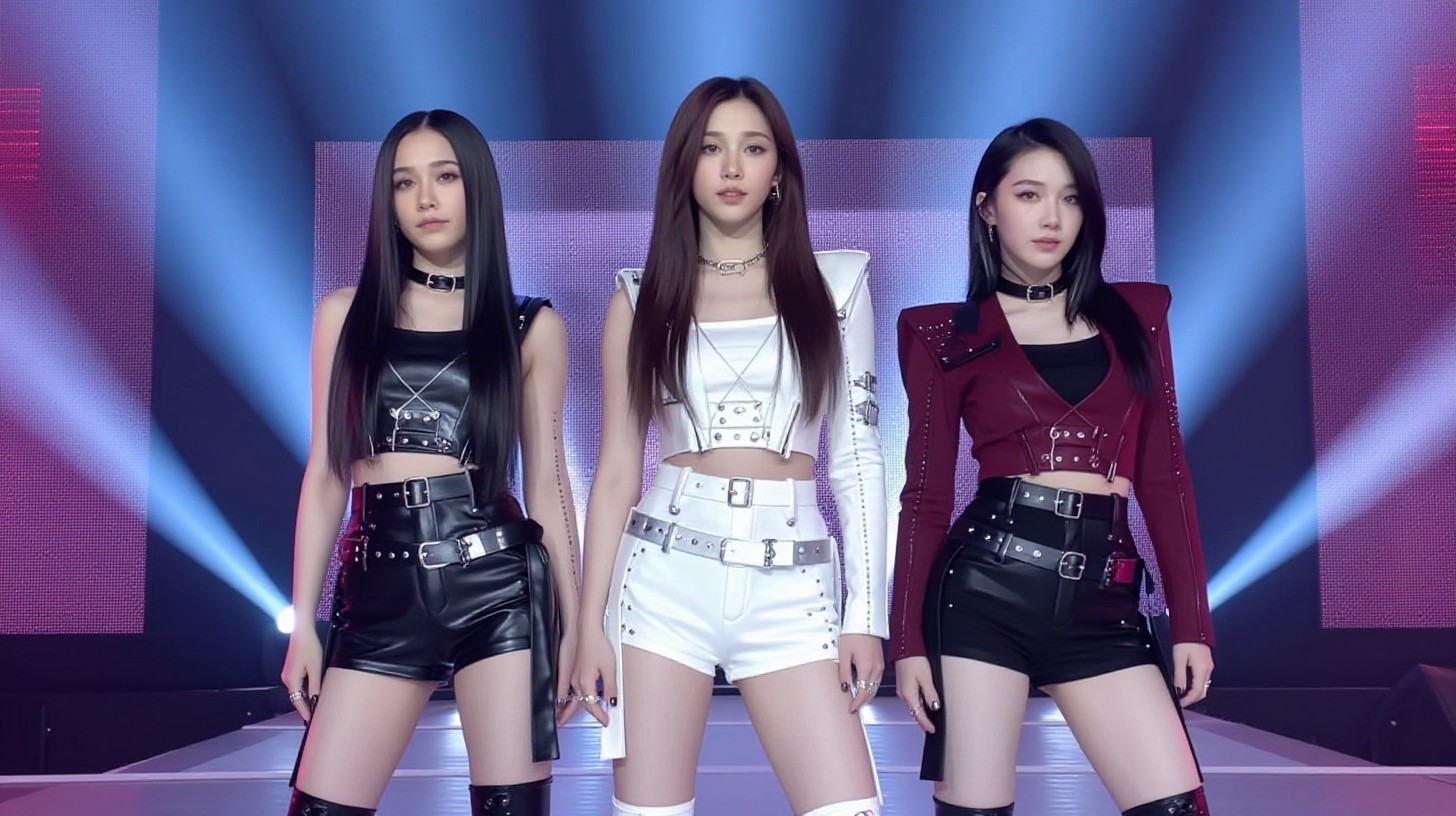
画像・動画・音声にそれぞれ役割を指定する
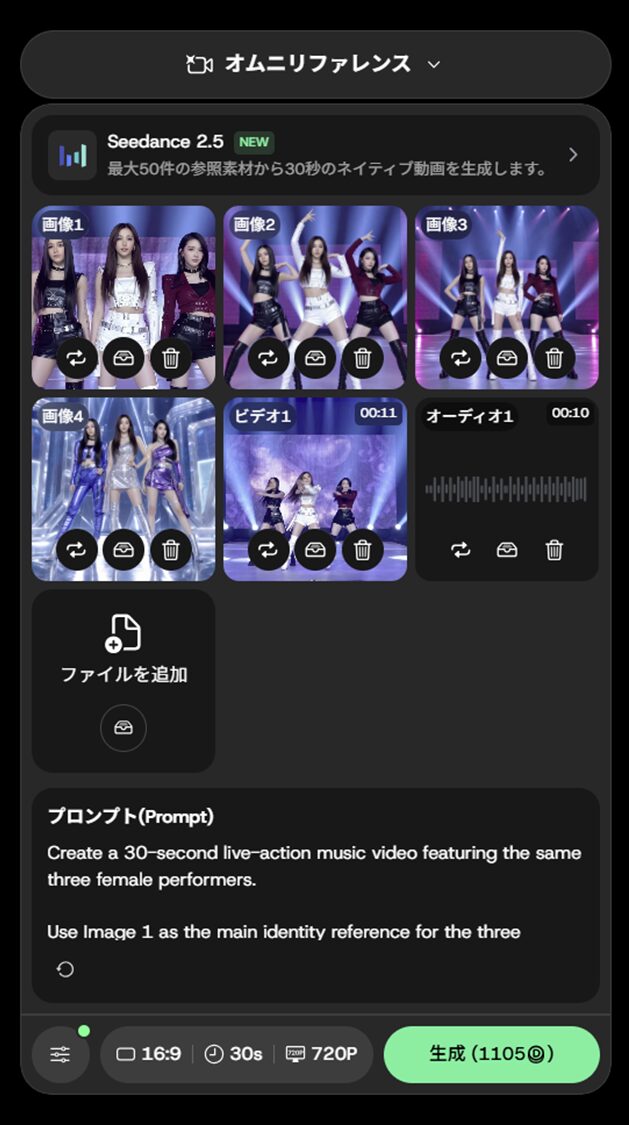
用意した6つの素材をオムニリファレンスへ追加し、プロンプト内でそれぞれの役割を指定しました。
| 素材 | 指定した役割 |
|---|---|
| 画像1 | 3人の外見、第1衣装、冒頭のステージ |
| 画像2 | 前半のダンスポーズ |
| 画像3 | 終盤の決めポーズ |
| 画像4 | 後半の第2衣装と新しいステージ |
| 動画1 | ダンスの動き、カメラワーク、カットのテンポ |
| 音声1 | MVの音源 |
参照させた動画はこちらです。
実際に入力したプロンプトは以下で確認できます。
30秒の中でも、0〜15秒は第1コンセプト、15秒以降は画像4を参照した第2コンセプトへ切り替えるよう指定しました。終盤では画像3のポーズを参照させています。
実際に使用したプロンプトを見る
Create a 30-second live-action music video featuring the same three female performers.
Use Image 1 as the main identity reference for the three performers, their first performance look, and the opening concert stage.
Use Image 2 as a choreography pose reference for the early dance performance.
Use Video 1 as the main reference for dance energy, camera rhythm, shot changes, and music-video-style editing.
Use Audio 1 as the soundtrack reference.
Use Image 4 as the second music-video concept for the later part of the video, with the same three performers changing into the futuristic second outfits and performing on the new icy blue metallic stage.
Use Image 3 as the ending pose reference for the final performance moment.
Keep exactly three performers throughout the entire video. Preserve each performer’s face, hairstyle, and left-center-right identity consistently.
Timeline:
0-8 seconds: Start from the Image 1 concept. Show a wide performance shot, then medium shots, with energetic synchronized three-member choreography.
8-15 seconds: Increase the dance energy and use dynamic camera movement, tracking shots, and closer performance shots inspired by Video 1.
15-20 seconds: Transition into the second music-video concept from Image 4. Keep the same three performers but clearly change their outfits, stage design, lighting, and overall atmosphere.
20-27 seconds: In the second concept, continue the performance with stylish synchronized choreography, multiple cinematic cuts, and stronger stage presence.
27-30 seconds: End with a dramatic final performance moment inspired by Image 3, finishing with a strong ending pose and a confident final shot.
Use music-video-style editing, multiple cuts, close-ups, medium shots, wide shots, and dynamic camera movement. Keep the performance energetic from the beginning. No extra people. No text.
生成条件は16:9・30秒・720P・オーディオオンに設定しました。消費クレジットは1,105でした。
30秒MVでは複数の参照素材を1本の映像に反映できた
今回作成した動画はこちらのようになりました。
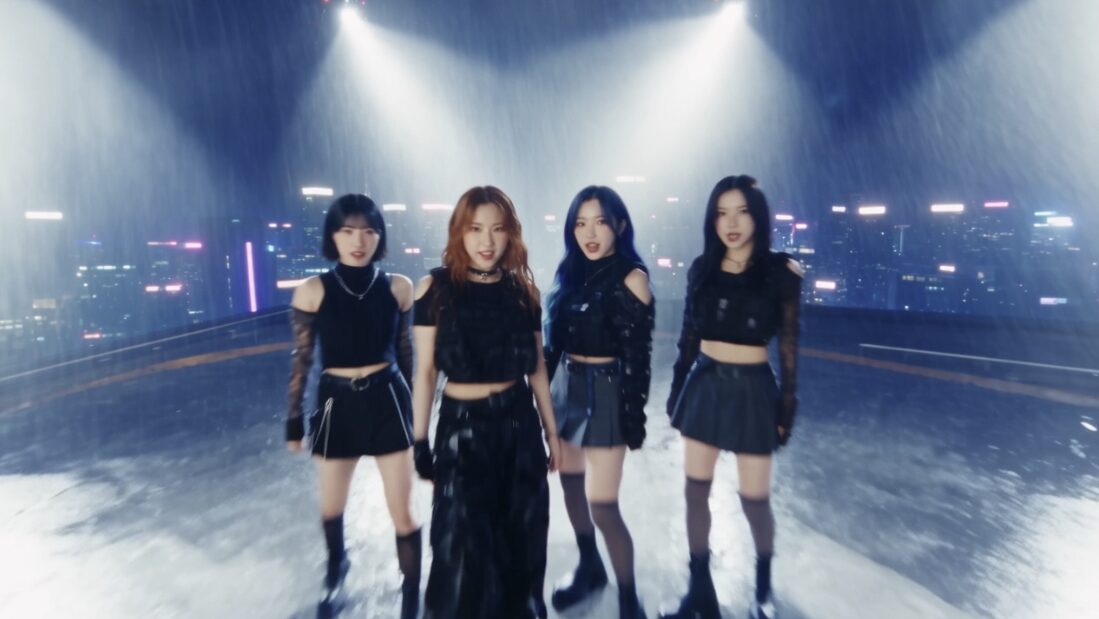
完成した動画では、約30秒を通して3人の人数や髪型を維持しながら、指定した素材が場面ごとに使い分けられました。
動画1の影響は冒頭から明確で、ダンスの雰囲気だけでなく、画角を切り替えるテンポまで参照されています。
画像2で指定したポーズも映像内に反映されましたが、その姿勢へ移った場面は直前より動きが小さくなり、ポーズをしばらく保持するような若干不自然な映像になってしまいました。静止画の姿勢を強く参照させると、前後のダンスとの動きの差が目立つようです。
15秒を過ぎると光を使ったトランジションが入り、3人の衣装とステージが画像4の第2コンセプトへ切り替わりますが、人物そのものは同じ3人として維持されています。
終盤では第2コンセプトの衣装やステージを残したまま、画像3を参照したポーズが生成されました。画像3の背景や衣装をそのまま再現するのではなく、画像3からポーズ、画像4から衣装とステージ、動画1からダンスとカメラワークを参照した結果になっています。
\ MiraLab AI限定!下記のリンクから購入で10%OFF /
MiniMax H3で2K・ネイティブステレオ音声のMVを制作
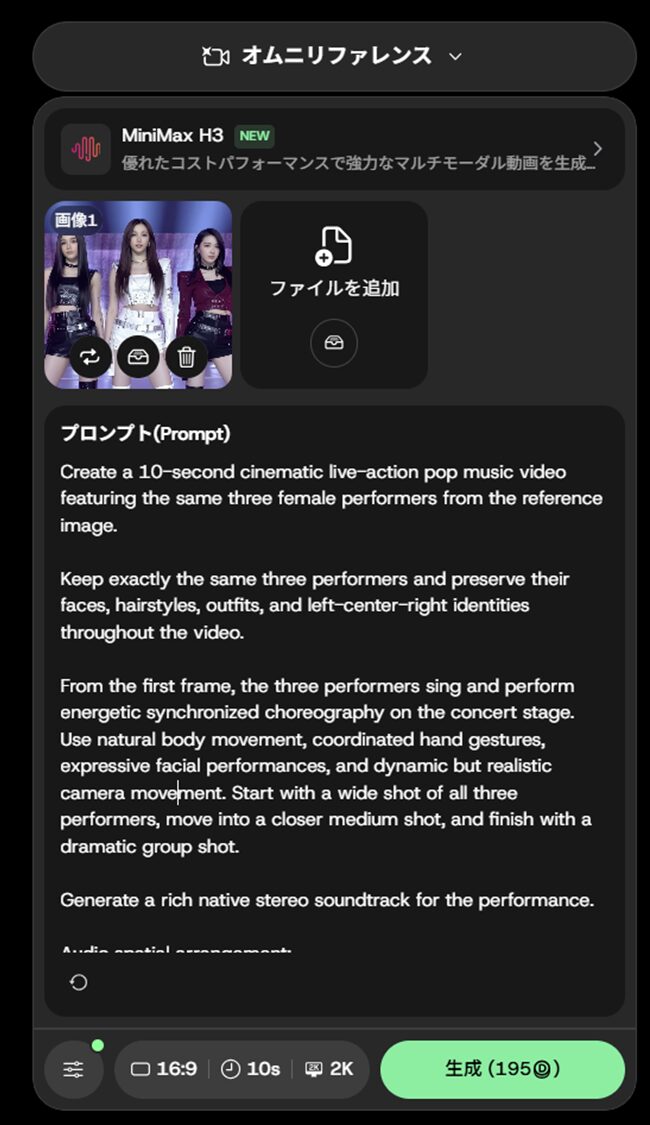
MiniMax H3では、2K出力とネイティブステレオ音声を試しました。3人組の実写風画像1枚から10秒のMVを生成し、左右で異なる楽器の配置をプロンプトで指定して、完成ファイルの映像と音声を確認しています。
2Kとステレオ音声を指定して10秒MVを生成する
今回はMiniMax H3自身が生成する音声を確認するため、参照素材は3人組の画像1枚だけに絞り、外部の音源や動画は追加していません。
生成条件は16:9・10秒・2K・オーディオオンです。音声はボーカルを中央、エレキギターを左、シンセサイザーと電子音を右、ベースとキックを中央へ配置するよう指定しました。映像では3人のダンスに加え、ワイドショットから人物へ近づき、最後に3人を映すカメラ構成を指示しています。
実際に使用したプロンプトは以下の通りです。
使用したプロンプトを見る
Create a 10-second cinematic live-action pop music video featuring the same three female performers from the reference image.
Keep exactly the same three performers and preserve their faces, hairstyles, outfits, and left-center-right identities throughout the video.
From the first frame, the three performers sing and perform energetic synchronized choreography on the concert stage. Use natural body movement, coordinated hand gestures, expressive facial performances, and dynamic but realistic camera movement. Start with a wide shot of all three performers, move into a closer medium shot, and finish with a dramatic group shot.
Generate a rich native stereo soundtrack for the performance.
Audio spatial arrangement:
- Lead vocal: centered
- Electric guitar: clearly positioned toward the left side of the stereo field
- Bright synthesizer and electronic effects: clearly positioned toward the right side
- Bass and kick drum: centered
- Supporting percussion and ambience: spread naturally across the stereo field
Make the left-right separation clearly audible while keeping the mix natural and musical. Create an energetic modern pop performance with synchronized music, vocals, choreography, stage lighting, and camera movement.
Exactly three performers. No extra people. No text.
今回の設定では、生成前に195クレジットと表示されました。
2K出力と左右に広がるステレオ音声を確認できた
完成した動画ファイルは2560×1440・24fps・約10.1秒で、DomoAI上で選択した2K設定が実際の出力にも反映されていました。3人の髪型や衣装も維持され、ダンスとカメラの接近、終盤のグループショットまで大きな破綻は見られません。
音声ファイルはステレオ2chで記録され、イヤホンで聴くとボーカルは中央から明瞭に聞こえ、背景の音には左右への広がりがありました。
左右チャンネルを解析すると、低音から中音域は中央成分が強く、高音域ほど左右差が大きくなっていました。プロンプトで中央に指定したボーカル、ベース、キックの配置とは一致する傾向です。
一方、「エレキギターは左、シンセサイザーは右」という指定については、楽器を左右にはっきり聞き分けられるほど強い分離にはなりませんでした。ステレオの広がり自体は確認できたものの、個々の楽器の定位までプロンプト通りに固定されたとは言えない結果となりました。
\ MiraLab AI限定!下記のリンクから購入で10%OFF /
同じ素材を使ってSeedance 2.5とMiniMax H3でAI MVを制作してみた比較
先ほど生成した画像を使って、Seedance 2.5とMiniMax H3へ同じキャラクター画像・10秒の音源・プロンプトを入力しました。
生成条件をできるだけそろえた場合に、人物の一貫性や動き、カメラワーク、音声にどのような違いが出るかを確認してみましょう。
アニメーション風AI MVシーンの比較
「DomoAIのオムニリファレンス機能でAI MVを制作するやり方」で紹介した方法で、Seedance 2.5とMiniMax H3のAI MVを比較していきます。
まずは、こちらがSeedance 2.5で制作した動画です。
次に、MiniMax H3で生成した結果はこちらのようになりました。
どちらの動画も約10秒を通して顔や髪型、白い衣装などのビジュアルが一貫して保たれ、崩れは全く見られませんでした。人物のモーションも入り、口や表情、上半身が自然に動き、髪と衣装にも風になびく表現が入っています。
Seedance2.5は、MiniMax H3と比較すると、後半に指定した横方向へのカメラワークはやや控えめな印象です。
MiniMax H3は、さらに手の動きも入り、シーンとしてかなり自然でした。少し気になったのは8秒付近で、歌声が無いシーンでキャラクターの口が動いていました。
印象的だったのは音声で、入力した音源には歌声を入れていないにもかかわらず、どちらの完成動画にも女性の歌唱が追加されています。明確な歌詞はなさそうですが、映像と音楽の雰囲気にはかなり自然に馴染んでいました。また、何も指定していなくてもキャラクターの口の動きは歌唱にほぼ完全に同期されています。
Seedance 2.5では、元の音源から電子音がなくなっていましたが、MiniMax H3は音源がそのまま使われているようです。音声もMiniMax H3の方がクリアに聞こえました。
3人組ユニットのAI MVシーンの比較
次に、実写ベースのMVをSeedance 2.5とMiniMax H3で生成しました。
メイン画像として、DomoAIで3人組の実写風ステージ画像を生成しました。左・中央・右の人物で髪型や衣装を分け、動画化した際に3人の外見が維持されているか確認できるデザインにしています。
以下のプロンプトを入力し、Seedance2.5とMiniMax H3でそれぞれ動画を生成しました。
動画生成に使用したプロンプトを見る
Create a dynamic live-action pop music video featuring the same three female performers from the reference image. Preserve each performer’s face, hairstyle, outfit, and identity consistently throughout the video.
From the very first frame, all three performers begin energetic synchronized choreography to the rhythm. They perform coordinated arm movements, side steps, body movements, turns, and expressive poses like a polished three-member pop dance performance. Keep the choreography continuous and clearly visible, with no long moments of standing still.
Use multiple cinematic shots and cuts during the 10-second video:
0-3 seconds: Start with a wide full-body shot of all three performers already dancing together. The camera moves slightly forward while they perform synchronized choreography.
3-6 seconds: Cut to a closer medium shot. Emphasize their facial expressions, singing, hand gestures, and upper-body choreography while keeping the performance energetic.
6-8 seconds: Switch to a dynamic angled tracking shot moving across the performers as they continue dancing. The stage lights pulse with the music.
8-10 seconds: Cut back to a dramatic wide shot of all three performers completing a synchronized dance move and final pose as the camera quickly pushes closer.
Use energetic concert lighting, dynamic camera movement, and music-video-style editing. Maintain realistic human anatomy and natural motion. Keep exactly three performers throughout the video. No extra people, no text.
まず、Seedance2.5の結果はこちらです。
次に、全く同じ画像とプロンプトで生成したMiniMax H3の動画がこちらです。
Seedance 2.5とMiniMax H3のどちらも、約10秒間にわたって顔や髪型、衣装をほぼ完璧に維持しました。髪や上半身、表情にも自然な動きが付き、大きな破綻は見られず、キャラクターの一貫性に明確な優劣はない結果でした。
一方で、今回の条件ではカメラワークと複雑な演出はSeedance 2.5の方が優勢に感じました。
指示では3秒・6秒・8秒ごとにシーンを指示しました。Seedance 2.5は指示とほぼ同じ約2.7秒、5.8秒、8.0秒で実際にカットを切り替えがありました。全身ショットから上半身、斜め方向のショット、最後の接近まで、指定した時間構成にかなり近い映像で、感動するほどの編集力でした。
MiniMax H3も3人を自然に踊らせましたが、大きなカット切り替えは約4秒と8秒付近で、少し指示とは異なりました。動作も腕や上半身を中心とした振り付けが続き、Seedance 2.5ほど変化は多くありません。
生成コストはMiniMax H3の方が大幅に低かった
10秒・16:9・音声ありで生成した際、Seedance 2.5は720Pで315クレジット、MiniMax H3は768Pで120クレジットが消費されました。
1本あたり195クレジットの差があり、Seedance 2.5はMiniMax H3の約2.6倍のクレジットを消費します。逆に見ると、MiniMax H3は今回の条件では約62%少ないクレジットで生成できました。
複雑な演出への追従ではSeedance 2.5が明確に上回った一方、MiniMax H3も人物の一貫性や基本的なダンス、カメラワークは十分な品質です。試作を何本も生成する場合は、1回あたりの消費が少ないMiniMax H3の方が回数を重ねやすくなります。
\ MiraLab AI限定!下記のリンクから購入で10%OFF /
まとめ
DomoAIのオムニリファレンスで利用できるようになったSeedance2.5とMiniMax H3では、静止画と10秒の音源から、人物の動きだけでなく歌唱、カメラワーク、複数カットまでまとめて生成することができました。
特にSeedance 2.5では、秒数ごとの構図や振り付けを細かく指定すると、実際にそこで画面が切り替わり、最後にはカメラへ手を伸ばすシメのポーズも入りました。AIに短い映像を作らせるというより、MV演出を文章で指示して編集までしてもらうような感覚に近く、完成映像を見たときはかなり驚きました。
MiniMax H3も、キャラクターをまったく崩さず動かせ、消費クレジットはSeedance 2.5よりかなり少ないです。ステレオ音声も確認できたため、音源へのこだわりをもった制作に強みがあります。
ただ、実際に試して、生成モデルを選ぶだけで完成度が決まるわけではないことも感じました。逆に言えば、素材だけでなく「何秒で誰をどう動かし、カメラをどう切り替えるか」までプロンプトに書くことで、編集せずとも高品質な映像が1発で生成できるレベルに最新のAIモデルは到達しています。
\ MiraLab AI限定!下記のリンクから購入で10%OFF /