
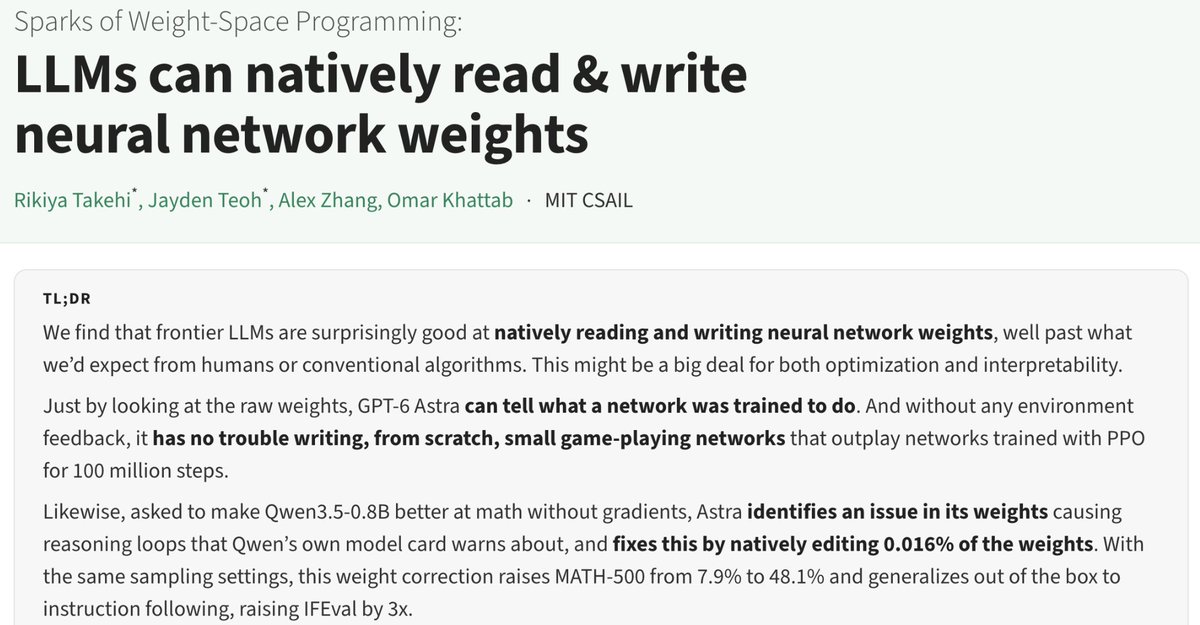
MIT CSAILのRikiya Takehi氏、Jayden Teoh氏、Alex Zhang氏、Omar Khattab氏らの研究チームは、最先端の大規模言語モデル(LLM)がニューラルネットワークの重みを自然言語で直接読み書きできるとする初期結果を、2026年11月2日付で公開しました。勾配降下法などの最適化手法を介さず、LLMが重みを直接扱うこの手法を「Weight-Space Programming」と呼んでいます。実験にはGPT-6 Astraが使われました。
読み取りの実験では、同じ構造の4つのネットワーク(重みは1万7253個)を与え、どのゲームを学習したかを尋ねました。選択肢は示していませんが、ブロック崩し、ポン、パックマン、フリーウェイの4つすべてを言い当てました。拡散モデルが生成する図形の推定でも、重みだけから円、三角形、四角形を特定しました。ただし実際は塗りつぶしの図形を生成するのに輪郭として描いており、研究チームは順伝播を計算せず重みの構造を読んでいる表れだと説明しています。さらに入出力の層を取り除いた720万パラメーターの文字レベル言語モデルでも、Python、ローマ字の日本語、英語のどれで学習したかを3つとも判別し、直前の文字列を複製する「コピーヘッド」の位置も実測と一致しました。
修正の実験では、PPOで学習した車がスロープを越えられず、256エピソードで一度も成功しない課題を扱いました。Astraが重みの3.5%を一度の返答で書き換えると、1024エピソードすべてで成功しました。
ゼロから重みを書く実験では、MinAtarの3ゲーム用ネットワークを、学習もツールの利用もなく生成させました。いずれも1億ステップ学習したPPOを上回りました。5億ステップのPPOと比べると、ブロック崩しは約20倍のスコアで、Asterixはほぼ並び、Seaquestは約60%でした。9×9の囲碁用ネットワーク(約148万個の重み)では、順伝播を0回しか使えない条件でも、小型のPPOネットワーク2つとの対局で半数超に勝ちました。順伝播を50回使える条件では、2000万局で学習した同規模のPPOネットワークを上回っています。
実際の言語モデルへの適用も試されました。Qwen3.5-0.8Bの数学性能を勾配なしで改善するよう求めると、Astraはモデルカードが警告する推論ループにつながる重みの問題を特定し、重みの0.016%を編集しました。同じサンプリング設定でMATH-500の正答率は7.9%から48.1%に上昇し、IFEvalのスコアも3倍になったといいます。
研究チームは、これらを今後の最適化や解釈可能性研究に影響しうる早期の成果と位置づけています。AdamやMuonといった従来のオプティマイザーに代わり、重みを推論してLLMが最適化する時代が近づいているとも主張しています。
出典:Sparks of Weight-Space Programming: LLMs can natively read & write neural network weights