米エヌビディアは9月23日、会話の中で「誰がいつ話したか」を判定する音声モデル「NVIDIA Nemotron 3 Diarization」を発表しました。重みを公開する1億パラメーターのモデルで、録音音声とリアルタイムの会話に対応し、最大8人の話者を区別します。複数人が同時に話す場面も扱えます。話者分離は各人が発話した時間帯を特定する技術です。音声認識の結果と組み合わせれば、発言者を示す文字起こしに利用できます。ただし、モデル単体は発言内容を文字に起こさず、出力する話者ラベルも実在の人物の身元を示すものではありません。
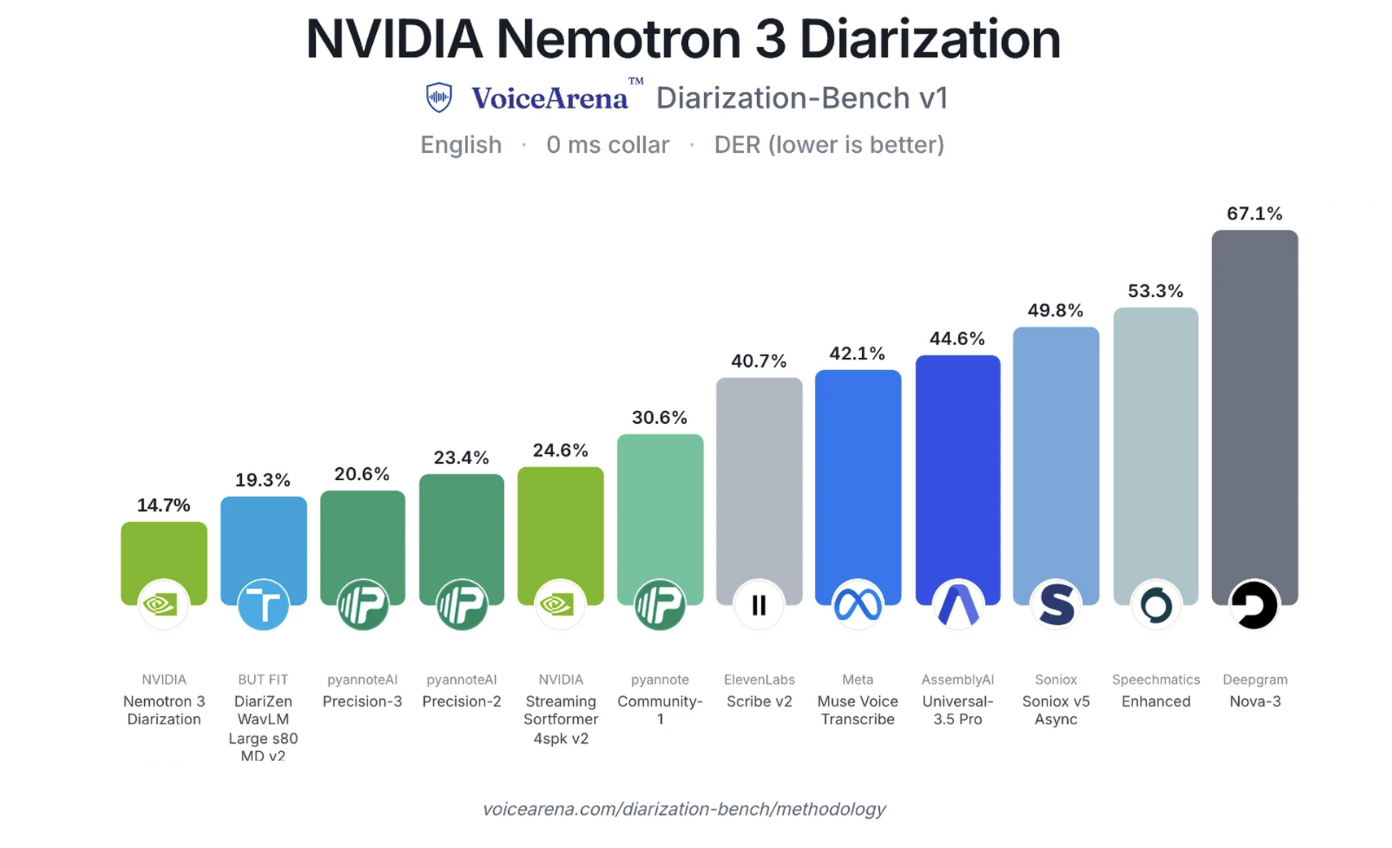
エヌビディアによると、VoiceArenaの初期評価では、英語の会話139件、合計約22時間を使い、12システムの計17構成を比較しました。同モデルの話者分離誤り率は14.72%で首位となり、次点の19.3%に比べて相対的に約24%低い結果でした。この指標には、発話の見落とし、発話していない区間の誤検出、話者の取り違えが含まれます。評価では発話の重なりも採点対象です。同社は、VoiceArenaによる評価と統計分析の完了後、順位や数値が変わる可能性も示しています。
従来の同社製ストリーミングモデル「Streaming Sortformer」は最大4人を対象としていました。新モデルは対応人数を8人に増やし、話者が最初に現れた順番で番号を割り当てます。この仕組みにより、音声を小分けにして処理する際も、同じ話者のラベルを維持します。過去に現れた話者の情報と直近の音声を参照する仕組みも備え、長さが異なる録音を分割して処理できます。
同社の評価では、入力音声を1.04秒ためてから処理する設定で、従来モデルと比べた誤り率が対象の8条件すべてで低下しました。各条件の相対的な改善率を単純平均すると41.0%です。これは全録音をまとめて算出した誤り率ではありません。推奨される入力バッファー時間は30.4秒、1.04秒、0.64秒、0.32秒の4種類で、短い設定ほど早く処理を始められる一方、一般に精度と処理能力は下がります。これらの時間には計算や通信、音声認識に要する時間は含まれません。
モデルは16kHzのモノラル音声を入力とし、NeMo Speechを通じて利用できます。ライブマイクや録音ファイルを試せるデモも公開され、Argmax Pro SDK 3にも対応しました。利用にはOpenMDW License Agreementのバージョン1.1が適用されます。エヌビディアは、8人を超える会話や強い雑音、反響、遠距離での収録などでは誤りが増える可能性があると説明しています。
出典:**Know Who Spoke When: Build Real-Time, Multi-Speaker AI with NVIDIA Nemotron 3 Diarization**