
Googleは10月28日、次世代のフロンティアモデル「Gemini 4 Carbon」を発表しました。Google DeepMindのSVPでGoogleのチーフAIアーキテクトを務めるコライ・カヴクチュオグル氏が公式ブログで明らかにしたもので、同社は「最先端のサイバーセキュリティ能力と長期的なタスク遂行能力を備えた最も強力なモデル」と位置づけています。2週間前に公開された「Gemini 4 Argon」を土台にしたモデルです。
同社によると、Carbonは更新されたArtificial Analysis Intelligence Index v5.0で59点を記録し、1位でした。コーディングやエージェント型タスクで大きく向上したほか、サイバー防御に欠かせない分野でも高い数値を示したということです。
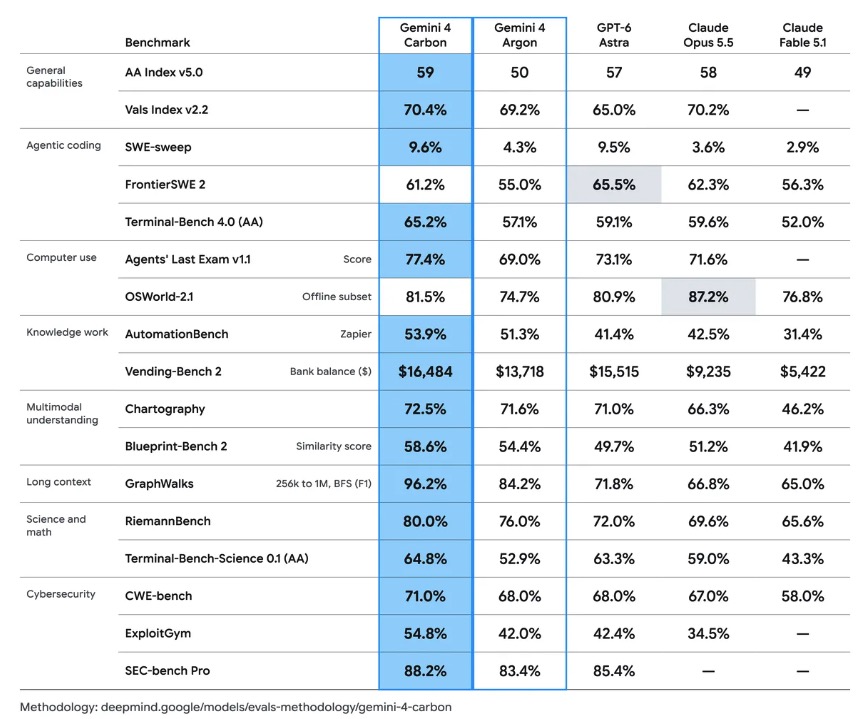
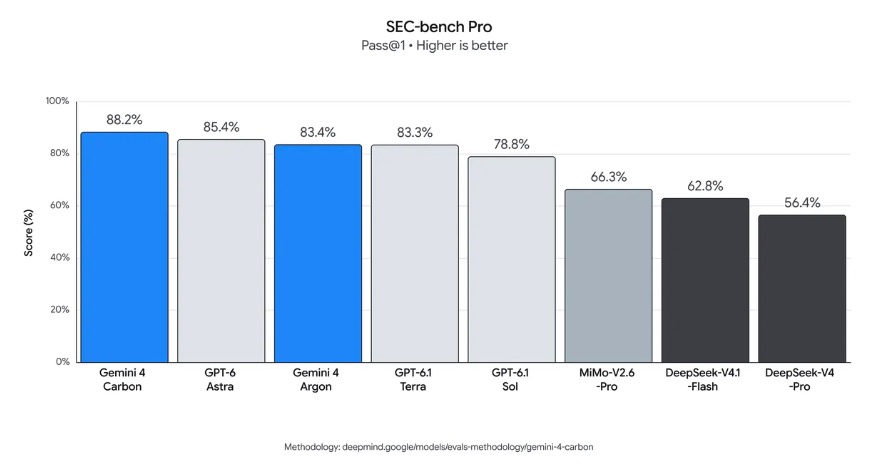
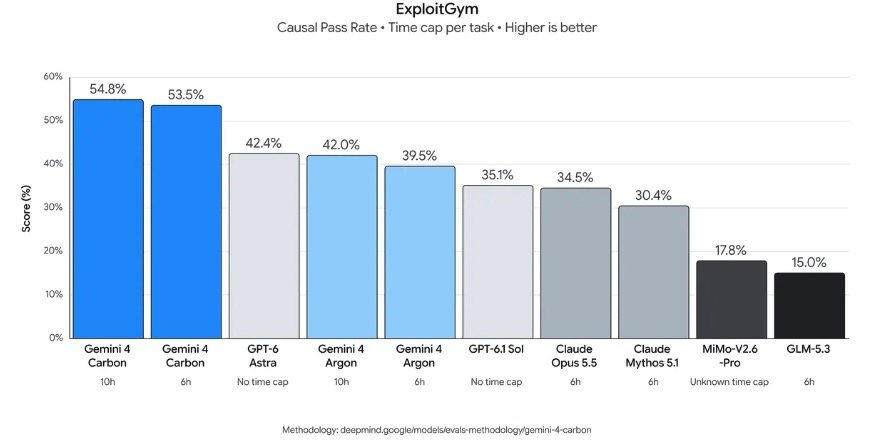
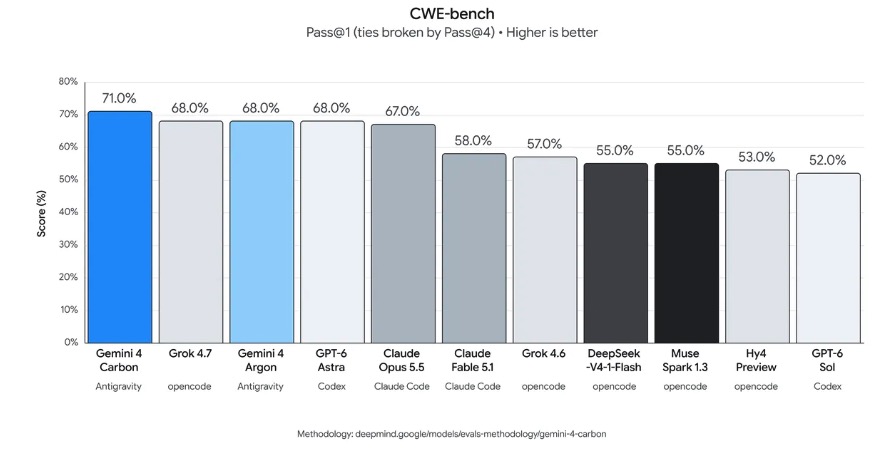
脆弱性の発見を測るSEC-bench Proは88.2%、悪用可能性の検証を測るExploitGymは54.8%、修正を測るCWE-benchは71.0%でした。これらの外部ベンチマークは、安全対策(ガードレール)なしで評価されています。社内ベンチマークでは、安全なコードを生成できる成功率がArgonの2倍超になりました。同社のChromeチームは、高品質な修正パッチの生成でCarbonが他社の大規模フロンティアモデルより10倍以上優れていたと報告しています。クラウドセキュリティ基盤のWizも、Webペネトレーションテストのベンチマークで首位だと確認しています。
Carbonは、より難度の高い長期的なエンジニアリング課題に取り組むために設計されました。社内では、大規模なコードベースや低レベルのシステムに潜む微妙なバグの原因特定と修正といった複数段階の作業を、行き詰まりを乗り越えながら数日間実行し続けた例があるそうです。Web開発の評価であるWebDev Arenaでは89 Eloポイント上昇し、1768で4位に入りました。
安全性の面では、Argonと同じ多層的な仕組みを引き継ぎました。モデルの訓練、リアルタイムの悪用対策、プロンプトインジェクション(外部から埋め込まれた悪意ある指示)への耐性、思考過程の監視を組み合わせたものです。Terminal-Bench 4.0では不正に成功する割合を0.0%に抑え、不正の試行も0.4%に減らしながら、全体の精度も高めたと説明しています。社内のライブコーディング環境では、重大度の高い不整合の警告が約80%減少しました。根拠のない主張はArgon比で約2分の1になり、指示の範囲を超える行動は26%、対応不足は29%それぞれ減ったとしています。Gray SwanのIPIベンチマークでは攻撃成功率が0.0%で、Argonの0.7%から下がりました。
提供は段階的に進めます。同社は米国政府による自主的なリリース前モデルテストの手続きに参加しており、今週から一部のサイバー防御担当者に提供を始めました。「Fairwind Program」を通じて、信頼できるパートナーへ順次広げる計画です。フィードバックを集めてガードレールを改良したうえで、開発者や企業、一般ユーザー向けにできるだけ早く提供するとしています。
料金はArgonと同じ導入価格で、入力100万トークンあたり2ドル、出力100万トークンあたり10ドルです。キャッシュされた入力トークンは入力価格から95%引きになります。