
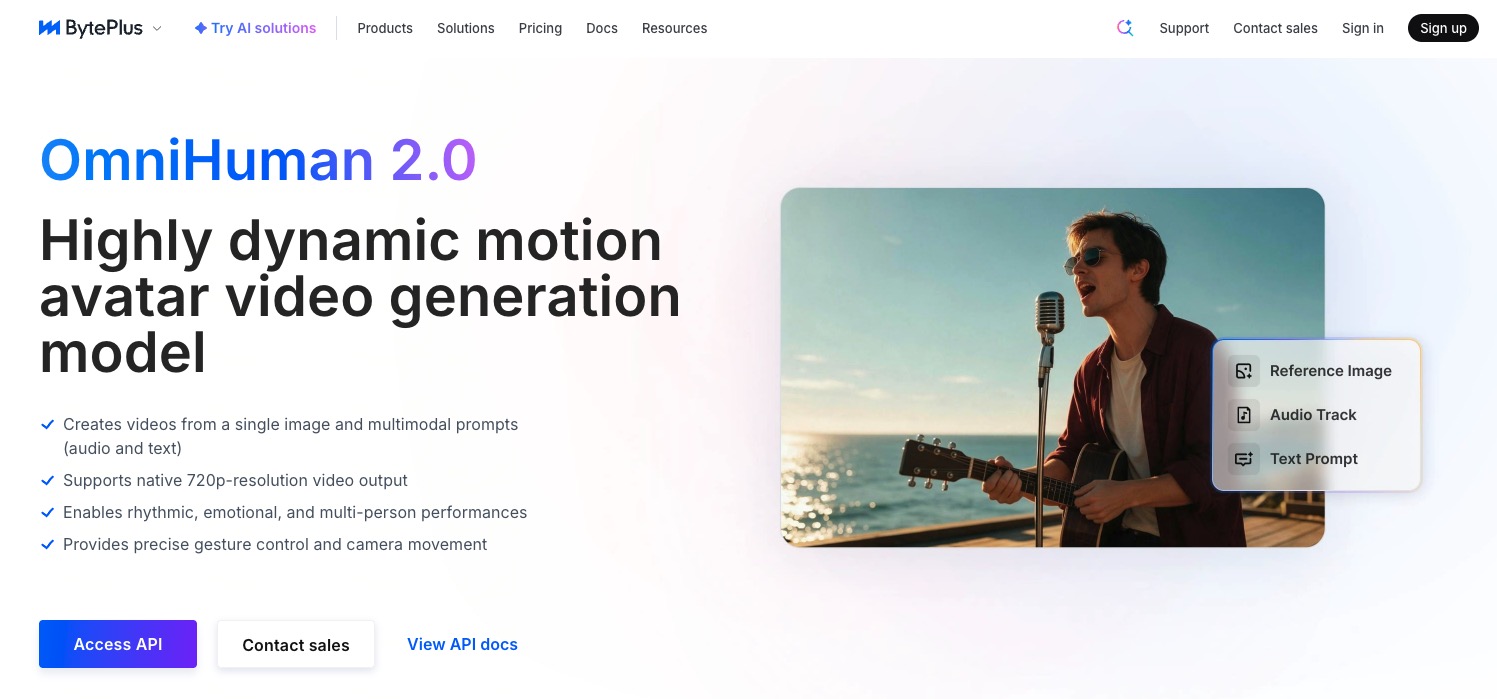
BytePlusは、1枚の画像と音声から人物などのアバター動画を生成するモデル「OmniHuman 2.0」を公開しました。同社の公式Xアカウントが2026年10月15日に投稿して知らせています。投稿では、単に口の動きを音声に合わせるだけでなく、音声の内容そのものを理解する点を特徴に挙げています。話し声や音楽、会話など、さまざまな音声を入力すると、トーンや感情、一語一語を読み取って演じる仕組みだと説明しています。さらに、最長5分の動画を途切れのない1回のショットで生成できるとしています。
同社の製品ページによると、OmniHuman 2.0は動きの大きなアバター動画を作るモデルです。1枚の画像に、音声とテキストといったマルチモーダルなプロンプト(指示)を組み合わせて動画を作ります。出力は720p解像度に標準で対応します。リズムのある演奏や感情表現、複数人が登場する場面にも対応し、ジェスチャーやカメラの動きを細かく指定できるとしています。
同社は、画像1枚と音声から、音声のリズムや抑揚、意味内容に沿った表情豊かなキャラクターのアニメーションを生成できると説明しています。テキストプロンプトは任意で、これを使うと生成結果をさらに調整できます。物体の生成やカメラワーク、特定の動作などを、テキストで細かく制御できる点も特徴として挙げています。
製品ページでは、用途ごとの表現力にも触れています。音楽の分野では、自然な間を取りながら動くデジタルシンガーを作れるとし、しっとりしたバラードから熱量の高いライブまで、ジャンルを問わず対応できると紹介しています。高音を含む歌唱にも対応できるそうです。演技の面では、音声の文脈を読み取って自然なジェスチャーや感情の変化を引き出し、言葉と意図をそろえた映画的な演技ができるとしています。
サンプル集では、猫や犬などの動物キャラクターを含め、より多くのスタイルや被写体に対応すると紹介しています。人型ではない画像や3D風の表現も扱えるといいます。参照画像にない要素をプロンプトで加えて特殊効果を作ったり、キャラクターと周囲の環境との自然なやり取りを描いたりすることもできます。音声の意味に関連した動作をキャラクターに演じさせることも可能だとしています。
料金は、映画のようなカメラワークや身体の動き、複数人の場面に対応するプランが1秒あたり0.07ドルです。同社は、このプランについて30秒から300秒までの動画を出力でき、コストは40%低く、動きも改善されたと説明しています。別枠として、1秒あたり0.12ドルのプランも掲載されています。こちらは1枚の画像と音声ファイルから、リップシンク(口の動きの同期)を重視した写実的なアバター動画を作る用途のものです。
想定される用途として、同社はEC、広告、ブランドマーケティング、ショート動画、映像作品を挙げています。AIミュージックビデオや、漫画・アニメ風キャラクターやペットを使ったUGC(ユーザー生成コンテンツ)、非現実的な内容のVlogなども例に示しています。利用にはAPIを通じてアクセスでき、製品ページにはAPIの資料や技術レポート、プロンプトの手引きへの案内があります。